Servizi affidabili, senza un team dedicato al monitoring.Monitoraggio infrastruttura che funziona.
Bleemeo offre al vostro team visibilità completa su server, container e cluster Kubernetes — dashboard, avvisi e log pronti dalla prima installazione. Individuate gli incidenti prima dei vostri clienti, i vostri ingegneri restano concentrati sul prodotto e il prezzo per server mantiene la fattura prevedibile. Azienda europea, dati archiviati nell'UE.
Nessuna carta di credito richiesta • 15 giorni di prova gratuita • In produzione in 5 minuti
Un monitoraggio che anticipa
Una data, non un grafico rosso
Bleemeo prevede quando disco, memoria e swap si esauriranno, a partire dal vostro storico, e mette la data nel report settimanale.
Anomalie segnalate, nessuno svegliato
Un modello Chronos-Bolt impara due settimane di ogni metrica e segnala ciò che esce dalla sua fascia abituale. Contesto per la reperibilità, non una sveglia alle 3 di notte.
Chiedete al vostro assistente IA
Il nostro server MCP offre a Claude, ChatGPT, Mistral Le Chat o Cursor oltre 30 strumenti in sola lettura: query PromQL, metriche, eventi e log.
Standard aperti, nessun lock-in
PromQL, Prometheus remote write e OpenTelemetry in ingresso; un agente Go open source (Glouton) sui vostri host.
Un'unica piattaforma
Ogni server, container e servizio — un unico posto per tenerli d'occhio
Installate un agente su Linux, Windows o Kubernetes e ogni servizio della macchina viene rilevato automaticamente — MySQL, PostgreSQL, Redis, Nginx e molti altri. I servizi AWS e Azure arrivano tramite le loro API, i dispositivi di rete via SNMP e i log finiscono nello stesso strumento. Un'unica vista su server, container, database e cloud, senza dover mettere insieme quattro prodotti.
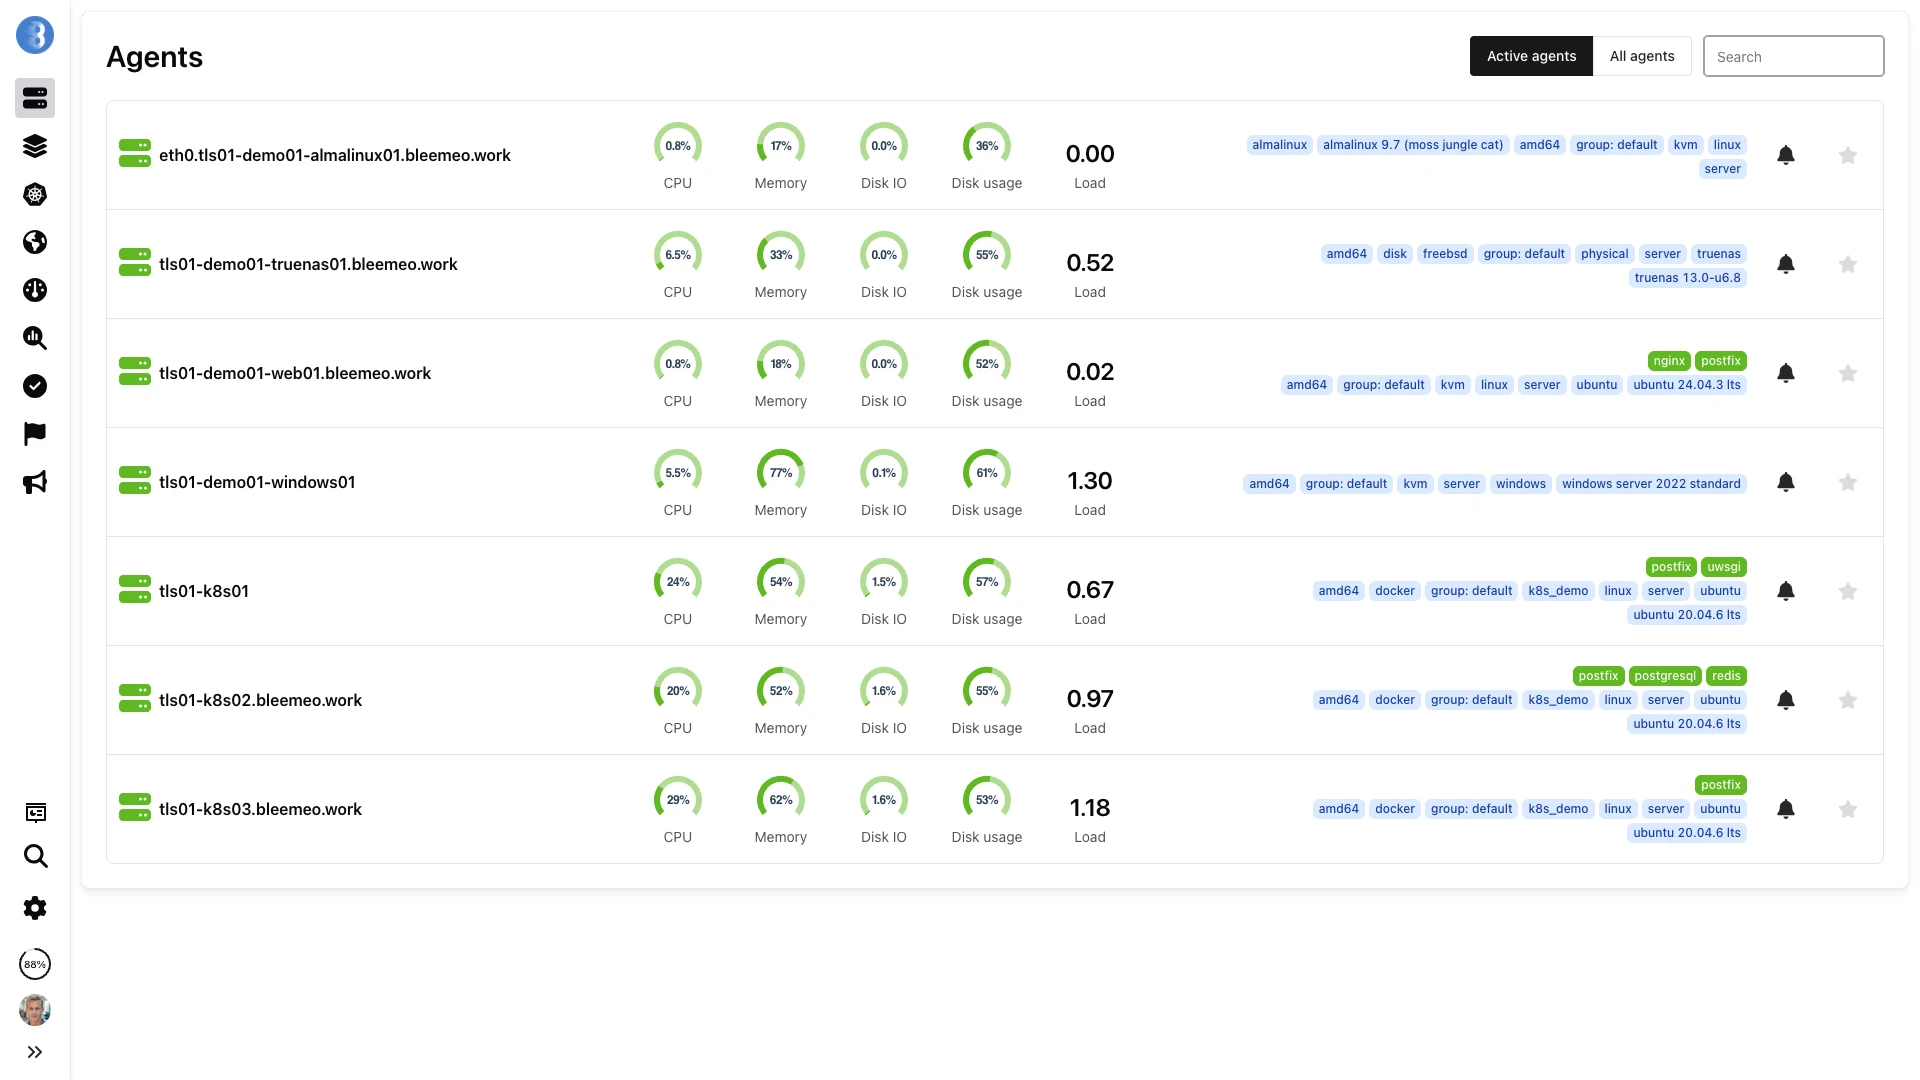
Team che rilasciano prodotto invece di sorvegliare dashboard
Dalle startup SaaS alle medie imprese, 500+ aziende si affidano a Bleemeo per tenere la produzione sotto controllo

Cosa dicono i nostri clienti
Ingegneri e CTO si affidano a Bleemeo per monitorare la loro infrastruttura
Abbiamo bisogno che i nostri team restino concentrati sul nostro core business — il digital signage — piuttosto che sul monitoraggio dell'infrastruttura. Bleemeo supervisiona l'intero ambiente, dal server dedicato ad Azure, e libera i nostri team dagli alert inutili garantendo al contempo la nostra qualità del servizio.
Il deployment di Bleemeo è stato incredibilmente veloce. In circa un'ora lo abbiamo distribuito su più di 100 server e abbiamo immediatamente ottenuto piena visibilità sulla nostra infrastruttura.
Abbiamo distribuito Bleemeo su tutta la nostra infrastruttura server in poche ore. Il monitoraggio dell'uptime ci avvisa istantaneamente ogni volta che un servizio riscontra un problema.
Confronto
Costruirlo, pagarlo troppo o semplicemente usarlo
Costruire il proprio stack, acquistare una piattaforma enterprise o scegliere la via di mezzo: ecco quanto costa davvero ogni opzione, tempo di ingegneria incluso.
Open Source DIY
Prometheus + Grafana + Alertmanager + Thanos + ... o Zabbix, Nagios, Centreon, Checkmk- Settimane di configurazione e messa a punto iniziale
- Manutenzione e aggiornamenti continui
- Pianificazione dello storage e gestione della capacità
- L'alta disponibilità è un vostro problema
- Controllo totale su tutto
- Nessun costo di licenza ricorrente
Adatto se avete già un team piattaforma esperto di monitoring e tempo da dedicarci.
- Ricco di funzionalità e potente
- Infrastruttura gestita
- Prezzi complessi: voci separate per host, log, APM e metriche personalizzate
- Fatture che crescono più velocemente della vostra infrastruttura
- Curva di apprendimento ripida
- Spesso più strumento del necessario
Costruito per grandi aziende con grandi budget e grandi team.
Bleemeo
Monitoring chiavi in mano per team in crescita- Pronto in produzione in 5 minuti
- Prezzi semplici per host, nessun costo nascosto
- Scoperta automatica di 100+ tecnologie
- 13 mesi di retention inclusi
- Compatibile Prometheus e OpenTelemetry
- Azienda europea, residenza dati UE
Tutta la visibilità di cui avete bisogno, senza la complessità superflua.
Quanto costa davvero il self-hosting
Chi monitora il monitoraggio?
Se il server di monitoraggio cade insieme al resto, nessuno riceve l'alert. Bleemeo gira fuori dalla vostra infrastruttura.
Aggiornamenti e patch di sicurezza
Prometheus, Grafana, Alertmanager e Thanos sono quattro cicli di rilascio da seguire. Su Bleemeo, nessuno.
Alta disponibilità
Almeno due istanze, per non perdere alert durante una manutenzione.
Retention
Prometheus conserva 15 giorni di default; oltre servono Thanos o Mimir e uno storage a oggetti. Bleemeo conserva 13 mesi in Professional.
Per 50 server su 3 anni, il nostro calcolatore conta 17 giorni-ingegnere all'anno di manutenzione a 450 € al giorno, 14 giorni di installazione e una coppia in alta disponibilità: 39.397 € in autogestione, contro 19.782 € con Bleemeo Professional.
Fate il vostro calcolo →Fondamenti
Cosa ci guadagna il vostro team
Gestiamo l'intero stack di monitoraggio — raccolta, storage, dashboard, alert e retention a lungo termine — e il tempo che il vostro team dedicherebbe a Prometheus, Grafana, Alertmanager e Thanos torna al vostro prodotto.
Visibilità dal primo minuto
Installate un agente e tutto viene scoperto automaticamente. Nessun exporter da configurare, nessun target di scrape da gestire, nessuna dashboard da costruire da zero. Glouton rileva i servizi tramite sonde TCP e si adatta quando il vostro stack cambia — senza riavvio.
Una fattura che potete prevedere
Prezzo semplice per host, senza fatture a sorpresa. Con Professional, ogni server include 1.000 metriche e 20 container; i log sono a consumo, per GiB, e utenti, dashboard e avvisi non sono mai fatturati. Sapete sempre quanto pagherete.
Avvisi già calibrati per voi
Dashboard preconfigurate, regole di avviso predefinite e 13 mesi di retention inclusi. Visibilità reale in pochi minuti, non settimane di configurazione.
Niente da ospitare, patchare o aggiornare
Dimenticate la capacità dello storage, la federazione, l'alta disponibilità e gli aggiornamenti. Noi gestiamo la piattaforma — voi la usate e basta. Nessun database time series da ottimizzare, nessuna politica di retention da configurare, nessuna strategia di backup da pianificare per i vostri dati di monitoraggio.
Tutto ciò che ci si aspetta da un monitoraggio, incluso
Le basi che uno strumento di monitoraggio deve fare bene, riunite in un unico posto, senza nulla da installare da parte nostra.
Raccogliere
- Server Linux e Windows
- Docker e Kubernetes
- Dispositivi di rete SNMP
- VMware vSphere, AWS e Azure
- 100+ integrazioni, exporter Prometheus, OTLP
- Check personalizzati, inclusi i plugin Nagios
Visualizzare
- Dashboard in tempo reale e modelli
- 13 mesi di retention (Professional)
- Ricerca nei log
- Check di uptime da 7 località, scadenza SSL e dominio
- Pagine di stato pubbliche
Allertare
- Soglie predefinite pronte all'uso
- Regole di alert PromQL
- Slack, Teams, PagerDuty, Opsgenie, ilert, email, SMS, webhook
- Reperibilità ed escalation
- Silenzi per le finestre di manutenzione
- App iOS e Android
Amministrare
- Utenti, ruoli e 2FA
- Registro di audit
- API REST
- Server MCP
- Report settimanale
Monitoraggio server
Monitoring server che si configura da solo
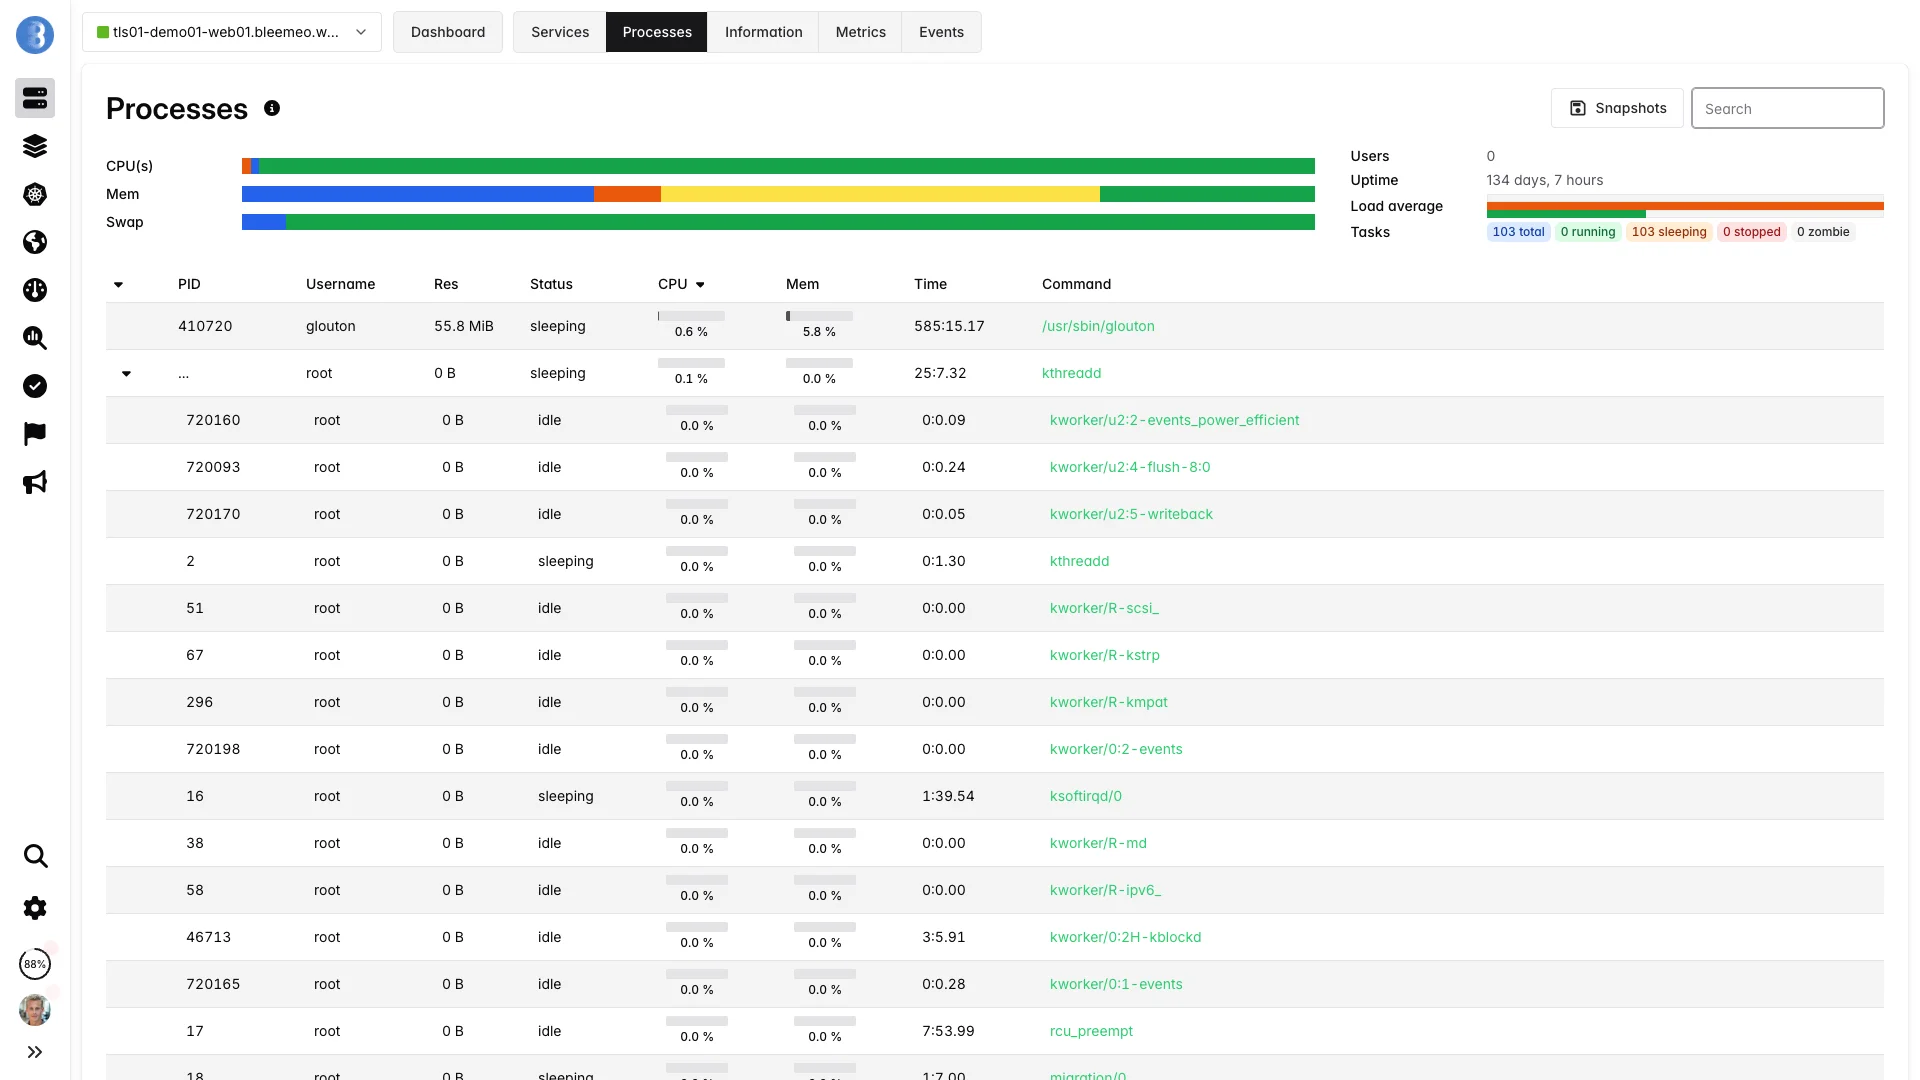
La maggior parte degli strumenti di monitoring richiede di definire cosa monitorare, scrivere file di configurazione e costruire dashboard prima di vedere una singola metrica. Con Bleemeo, installate un agente leggero e lui fa il resto.
Glouton, il nostro agente open-source, scopre automaticamente ogni servizio in esecuzione — database, server web, code, container — e inizia a raccogliere metriche con risoluzione a 10 secondi. Dashboard e avvisi sono pronti prima che finiate il caffè.
Copertura
Da 5 a 500 server, un solo strumento
Monitoraggio completo per ogni parte della tua infrastruttura
Monitoraggio server
Server fisici e virtuali, VM e infrastruttura bare-metal. Monitora metriche di sistema, processi e servizi.
Scopri il monitoring dei server →Monitoraggio Kubernetes
Osservabilità completa di Kubernetes. Monitora cluster, nodi, pod e servizi con scoperta automatica.
Scopri il monitoring Kubernetes →Monitoraggio applicazioni
Monitora database, server web, code di messaggi e applicazioni personalizzate. Traccia prestazioni e disponibilità.
Scopri il monitoring delle applicazioni →Monitoraggio container
Metriche Docker e container. Monitora utilizzo risorse, salute e prestazioni su tutta la tua flotta di container.
Scopri il monitoring dei container Docker →Monitoraggio di rete
Traccia prestazioni di rete, utilizzo banda e connettività. Monitora switch, router e load balancer.
Scopri il monitoring di rete →Monitoraggio cloud
AWS, Azure, GCP e ambienti multi-cloud. Visibilità unificata su tutta la tua infrastruttura cloud.
Scopri il monitoring AWS →Gestione log
Log accanto alle vostre metriche, fatturati a GiB
Con la maggior parte dei fornitori di monitoring, i log sono un prodotto separato che richiede infrastruttura dedicata. Con Bleemeo, la raccolta dei log è integrata nello stesso agente che già utilizzate — nessuno stack ELK da distribuire, nessun Loki da configurare. Paghi solo per quello che ingerisci a 0,50€/GiB, senza costi nascosti di indicizzazione o sovrapprezzi di conservazione.
Prometheus
Amate Prometheus? Lasciate perdere le ops.
Prometheus è potente — e farlo girare in produzione significa occuparsi di storage, retention, federazione, alta disponibilità e una costellazione di exporter.
Bleemeo vi offre piena compatibilità PromQL con storage gestito a lungo termine e 13 mesi di retention. Mantenete il linguaggio di query che conoscete, lasciate a noi il peso dell'infrastruttura.
scrape_configs:
  - job_name: 'nodes'
    static_configs:
      - targets:
        - 'node1:9100'
        - 'node2:9100'

  - job_name: 'kubernetes'
    kubernetes_sd_configs:
- role: podOpenTelemetry
Portate la vostra strumentazione. Andatevene quando volete.
Utilizzate già OpenTelemetry o exporter Prometheus? Bleemeo accetta le vostre metriche e i vostri log così come sono. Nessun agente proprietario, nessun SDK specifico del vendor. La vostra strumentazione resta portabile — noi le diamo semplicemente una casa.
IA & ML
Avvisati prima, disturbati meno
I team piccoli non possono permettersi di rincorrere falsi allarmi. Bleemeo impara il ritmo quotidiano e settimanale di CPU, memoria e swap di ogni server e segnala le ore che escono dall'intervallo atteso — senza alcuna soglia da configurare e senza svegliare nessuno. Un secondo modello risponde all'altra domanda: non «è normale adesso?», ma «quando finisce?»
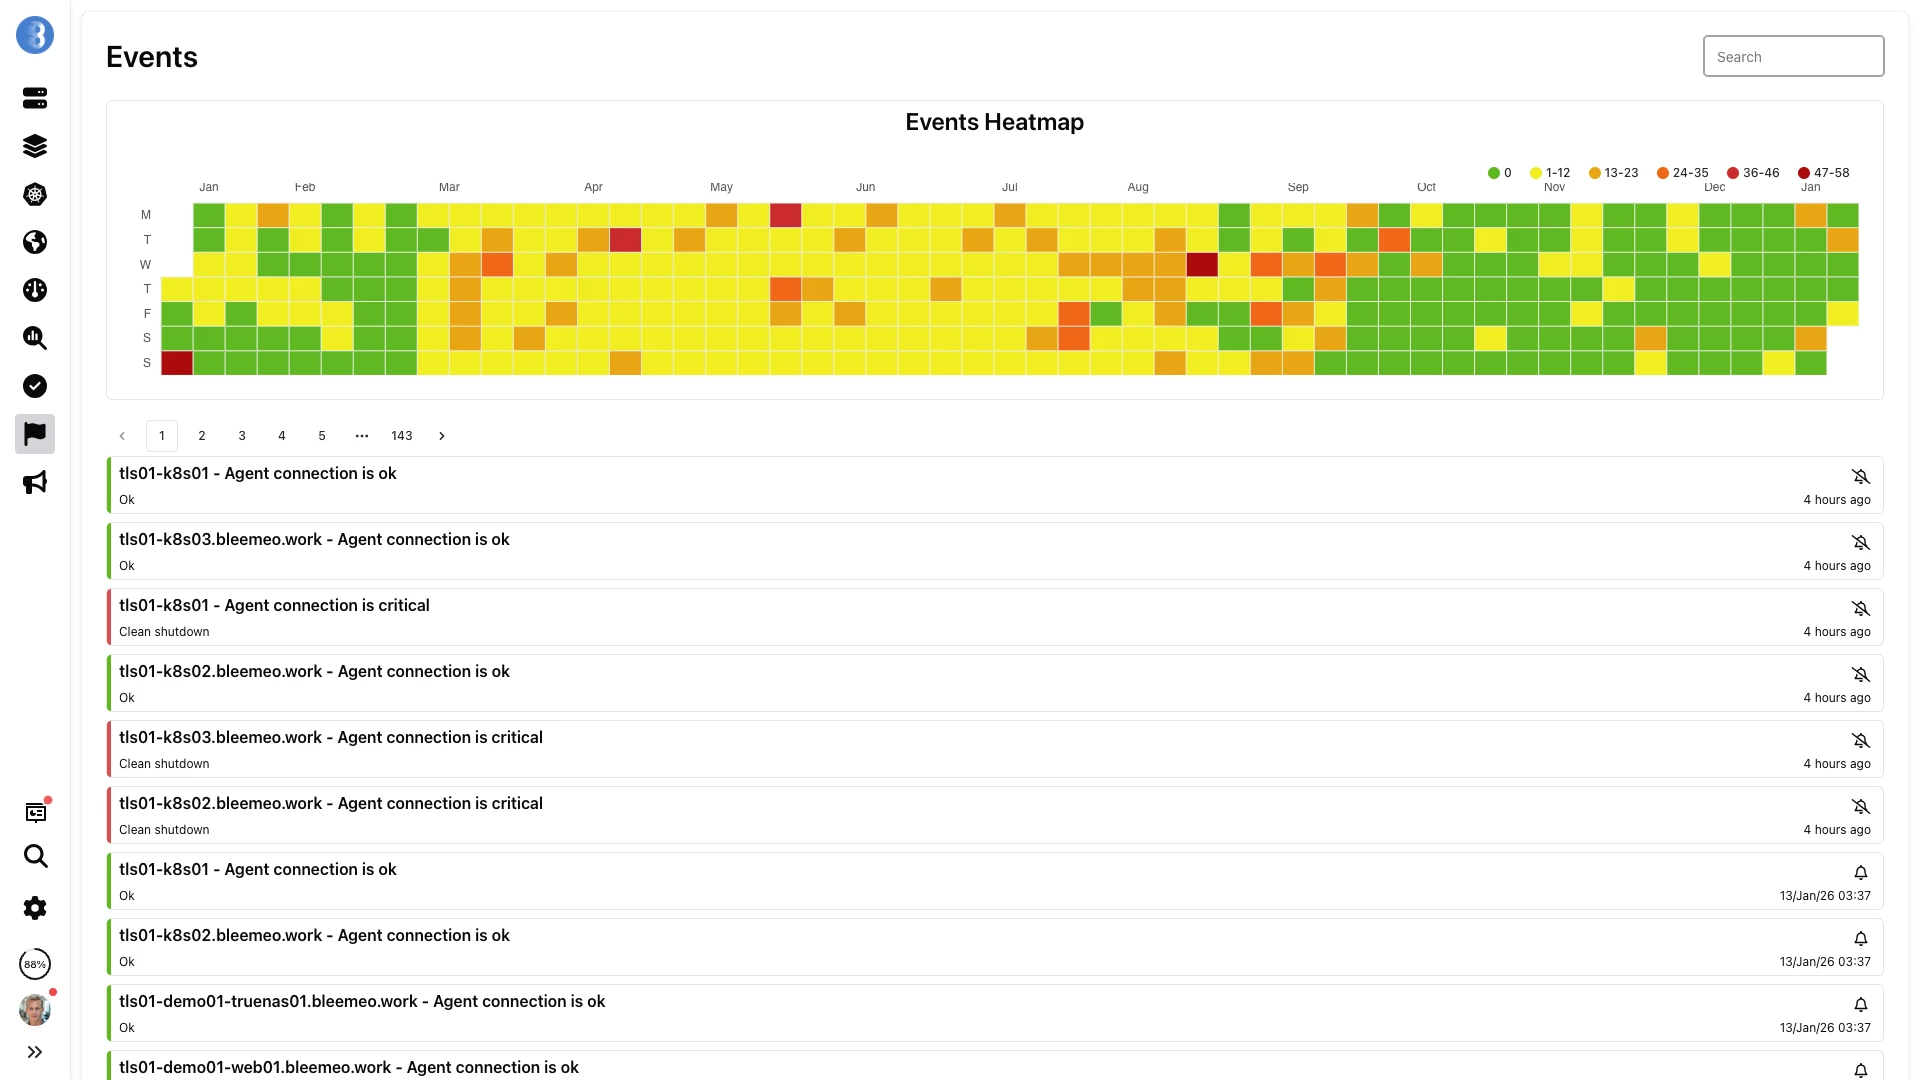
Un anno di eventi a colpo d'occhio — lo stesso storico che i modelli leggono per imparare com'è una settimana normale.
Rilevamento anomalie
Bleemeo impara il ritmo quotidiano e settimanale di CPU, memoria e swap di ogni server dalle ultime due settimane e segnala le ore che escono dall'intervallo atteso. Niente da configurare, e non vi sveglia mai: un'anomalia è un segnale, non una severità.
Previsione di capacità
Le tendenze di disco, memoria e swap vengono proiettate su una data, non su una percentuale: «questo volume raggiunge il 90 % il 3 aprile». Una data viene annunciata solo se la deriva si è confermata su due finestre — un servizio che parte e occupa metà della RAM non è una perdita.
Anticipo misurato
Ogni anomalia viene accostata al primo allarme che l'ha seguita sullo stesso host: l'interfaccia mostra lo scarto reale — «allarme 42 minuti dopo» — e l'anticipo mediano per vista. Vedete quanto vale il rilevamento sulla vostra infrastruttura.
Impara dalle vostre risposte
Ogni anomalia attende un sì o un no. I falsi allarmi ripetuti mettono da soli in pausa il rilevamento su quella metrica: un segnale rumoroso tace, invece di insegnare al team a ignorare la funzionalità.
Suggerimenti per ridurre il rumore Beta
Bleemeo raggruppa i vostri allarmi ricorrenti e propone il silence o la configurazione flappy che li farebbe tacere, precompilato e a un clic. Cercate nello storico degli eventi per significato invece che per parole esatte, e chiedete se qualcosa di simile è già stato visto.
Server MCP per assistenti IA
Collegate Claude, Cursor o VS Code tramite il nostro server Model Context Protocol. Oltre 30 strumenti in sola lettura permettono a un assistente di rispondere sulla salute della vostra infrastruttura — può leggere tutto e non modificare nulla.
Sicurezza
I vostri dati di monitoring sono la mappa della vostra infrastruttura. Li proteggiamo di conseguenza.
La sicurezza non è un componente aggiuntivo né una funzionalità riservata al piano enterprise — è integrata in ogni livello della piattaforma, dall'agente in esecuzione sui vostri server allo storage dove vengono conservati metriche e log.
Ogni agente si autentica con il cloud Bleemeo utilizzando credenziali uniche legate al vostro account. Non ci sono flussi di dati anonimi né endpoint condivisi — ogni fonte di metriche viene verificata prima che un singolo dato venga accettato. Sapete sempre esattamente cosa sta inviando dati al vostro account, e nulla di non autorizzato può iniettare dati falsi nelle vostre dashboard.
- Crittografia TLS 1.3 per tutti i dati in transito
- Crittografia AES-256 per tutti i dati a riposo
- Autenticazione per agente con credenziali uniche
- Controllo degli accessi basato sui ruoli e audit logging
Europeo
Un'azienda europea, non solo una regione europea
Qualsiasi fornitore può affittare un rack a Francoforte. Meno numerosi sono quelli che vi dicono con quale società state contrattando, sotto quale diritto, e cosa esce esattamente dai vostri server.
Contrattate con una società francese
Bleemeo è una società francese, fondata a Tolosa nel 2015 e diretta da lì. Siete fatturati in euro, sotto il diritto francese, con un responsabile della protezione dei dati davvero raggiungibile e un supporto nel vostro fuso orario — non un'entità statunitense con una filiale europea attaccata.
Le vostre metriche restano nella regione di Parigi
Metriche e log sono archiviati nell'Unione Europea, nella regione di Parigi. Una regione, una giurisdizione, con un nome — invece dei «data center europei» che scrivono tutti. L'elenco completo dei responsabili, compresi i pochi extra-UE coperti da clausole contrattuali tipo, è sulla pagina sicurezza.
Nessuna scatola nera sui vostri server
Glouton, l'agente che installate, è open source sotto licenza Apache 2.0. Ciò che raccoglie e ciò che invia si legge riga per riga. Per chi deve giustificare un fornitore, è una garanzia più solida di un badge di residenza.
Pagina di stato pubblica
Mostrate ai vostri clienti la disponibilità che garantite
Gli stessi check che allertano il vostro team alimentano una pagina di stato pubblica sul vostro dominio: salute dei servizi in tempo reale, incidenti in corso e storico della disponibilità. Un unico URL che il vostro supporto può condividere durante un incidente — nessuno strumento di status page da acquistare a parte, niente da aggiornare a mano.
Scopri il monitoraggio uptime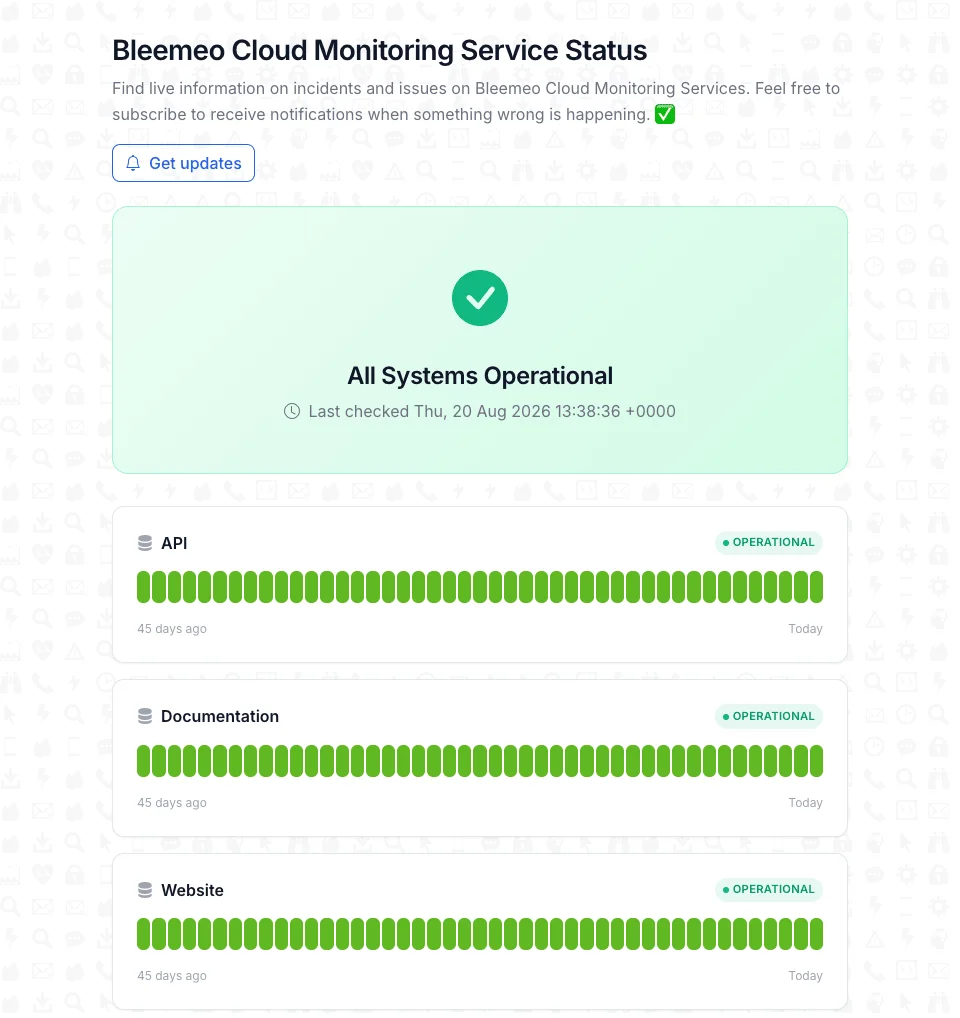
È la pagina di stato di Bleemeo stessa — guardatela dal vivo.
Domande frequenti
Tutto quello che devi sapere sulla piattaforma di monitoraggio Bleemeo
Come funziona la vostra piattaforma di monitoraggio?
Bleemeo utilizza un agente open-source leggero chiamato Glouton che installi sui tuoi server, VM o cluster Kubernetes. L'agente scopre automaticamente i servizi e le applicazioni in esecuzione, raccoglie metriche di sistema ogni 10 secondi e trasmette i dati in modo sicuro alla nostra piattaforma cloud. Da lì, ottieni dashboard in tempo reale, avvisi intelligenti e 13 mesi di retention delle metriche. Per i servizi cloud, ci integriamo direttamente con AWS CloudWatch e Azure Monitor. La piattaforma accetta anche dati tramite protocolli OpenTelemetry (OTLP).
Quali tipi di infrastruttura e applicazioni supportate?
Bleemeo supporta oltre 100 tecnologie pronte all'uso con scoperta automatica. Questo include: Sistemi operativi (Linux, Windows), Container (Docker, containerd, Kubernetes), Database (MySQL, PostgreSQL, MongoDB, Redis, Elasticsearch), Server web (Apache, Nginx, HAProxy), Code di messaggi (RabbitMQ, Kafka), Piattaforme cloud (AWS, Azure, GCP), e Dispositivi di rete via SNMP (Cisco, Ubiquiti, Dell). Supportiamo anche metriche personalizzate tramite StatsD, Prometheus exporters e strumentazione OpenTelemetry.
Come vi integrate con il mio stack esistente?
Bleemeo offre molteplici percorsi di integrazione: installa il nostro agente Glouton per il monitoraggio dell'infrastruttura senza configurazione, invia metriche via OpenTelemetry (OTLP), o connetti account cloud tramite integrazioni native. Per le notifiche, ci integriamo con Slack, PagerDuty, OpsGenie, Microsoft Teams, email, SMS e webhook personalizzati. Nessuna modifica al codice richiesta per il monitoraggio dell'infrastruttura - basta installare l'agente e i servizi vengono scoperti automaticamente.
Il vostro monitoraggio impatta le prestazioni del sistema?
No. Glouton è estremamente leggero — tipicamente meno dell'1% di CPU e meno di 100 MB di memoria. L'agente raccoglie le metriche in modo asincrono e raggruppa le trasmissioni per minimizzare il carico di rete, non entra mai in competizione con i vostri carichi di produzione.
Come garantite la sicurezza e la privacy dei dati?
La sicurezza è fondamentale per la nostra piattaforma: tutti i dati sono crittografati in transito con TLS 1.3 e a riposo con AES-256, e archiviati nell'UE (regione di Parigi) in conformità al GDPR. L'agente raccoglie metriche di sistema e dei servizi — più i vostri log se usate la gestione dei log — e poiché Glouton è open source, potete verificare esattamente cosa lascia i vostri server. Ogni agente si autentica con credenziali proprie tramite connessioni con certificate pinning, e l'accesso è protetto da permessi basati sui ruoli e logging di audit. La nostra infrastruttura è sottoposta a audit di sicurezza regolari.
Supportate metriche e log?
Sì, Bleemeo fornisce osservabilità completa per metriche e log. Le metriche sono raccolte ogni 10 secondi con 13 mesi di retention. I log possono essere raccolti e centralizzati attraverso il nostro agente con ricerca in tempo reale, filtraggio e capacità di alerting. Entrambi i tipi di dati possono essere correlati nelle nostre dashboard per un troubleshooting completo.
Quanto velocemente posso iniziare con la vostra soluzione?
Potete essere operativi in meno di 5 minuti. Installate l'agente Glouton con un solo comando — one-liner per Linux, installer per Windows, o Helm chart per Kubernetes. L'agente scopre automaticamente i vostri servizi e popola le dashboard immediatamente.
Cosa rende la vostra piattaforma diversa dagli altri strumenti di monitoraggio?
Bleemeo si distingue per: Semplicità - la scoperta automatica significa nessuna configurazione manuale di cosa monitorare. Agente open-source - Glouton è completamente open-source, nessuna scatola nera. Prezzi prevedibili - prezzo per host senza costi nascosti per metriche o volume dati. Retention lunga - 13 mesi inclusi, non 15 giorni. Azienda europea - residenza dati EU e approccio GDPR-first. Basato su standard - supporto nativo Prometheus e OpenTelemetry significa nessun vendor lock-in.
Supportate OpenTelemetry e Prometheus?
Sì. Bleemeo supporta entrambi gli standard nativamente. Per Prometheus, il nostro agente fa scrape degli exporter esistenti e PromQL funziona out of the box. Per OpenTelemetry, inviate metriche e log via OTLP (gRPC o HTTP) — nessuna modifica della strumentazione richiesta.
La vostra soluzione è adatta per ambienti cloud-native e ibridi?
Sì, Bleemeo è progettato per l'infrastruttura moderna. Per cloud-native: supportiamo Kubernetes con visibilità completa su cluster, nodi, pod e container tramite deployment Helm. L'auto-discovery gestisce automaticamente i workload effimeri. Per ambienti ibridi: monitora server on-premises, VM cloud, container e servizi gestiti da un'unica piattaforma. Il nostro agente funziona in modo identico in tutti gli ambienti, e le dashboard possono combinare metriche da tutte le fonti per una visibilità unificata.
Ultimi articoli dal blog
Approfondimenti, tutorial e best practice per il monitoraggio dell'infrastruttura

Affidabilità dimostrabile. Costi prevedibili.
Pronto per la produzione in 5 minuti — con lo storico di disponibilità da mostrare alla direzione e prezzi per server per pianificare il budget.
Prova gratuitaNessuna carta di credito richiesta • 15 giorni di prova gratuita • Accesso completo a tutte le funzionalità