Des services fiables, sans équipe dédiée au monitoring.Le monitoring d'infrastructure qui fonctionne.
Bleemeo donne à votre équipe une visibilité complète sur vos serveurs, conteneurs et clusters Kubernetes — tableaux de bord, alertes et logs prêts dès l'installation. Vous repérez les incidents avant vos clients, vos ingénieurs restent sur le produit, et la tarification par serveur garde la facture prévisible. Entreprise européenne, données stockées dans l'UE.
Aucune carte bancaire requise • 15 jours d'essai gratuit • Prêt en production en 5 minutes
Un monitoring qui anticipe
Une date, pas une courbe rouge
Bleemeo prévoit quand le disque, la mémoire et le swap seront saturés, à partir de votre historique, et met la date dans votre rapport hebdomadaire.
Anomalies signalées, astreinte épargnée
Un modèle Chronos-Bolt apprend deux semaines de chaque métrique et signale ce qui sort de sa plage habituelle. Du contexte pour l'astreinte, pas un réveil à 3 h.
Interrogez votre assistant IA
Notre serveur MCP donne à Claude, ChatGPT, Mistral Le Chat ou Cursor plus de 30 outils en lecture seule : requêtes PromQL, métriques, événements et logs.
Standards ouverts, pas d'enfermement
PromQL, Prometheus remote write et OpenTelemetry en entrée ; un agent Go open source (Glouton) sur vos machines.
Une seule plateforme
Chaque serveur, conteneur et service — un seul endroit pour tout surveiller
Installez un agent sur Linux, Windows ou Kubernetes : chaque service de la machine est détecté automatiquement — MySQL, PostgreSQL, Redis, Nginx et bien d'autres. Les services AWS et Azure remontent par leurs API, les équipements réseau en SNMP, et les logs arrivent dans le même outil. Une seule vue sur vos serveurs, conteneurs, bases de données et clouds, sans assembler quatre produits.
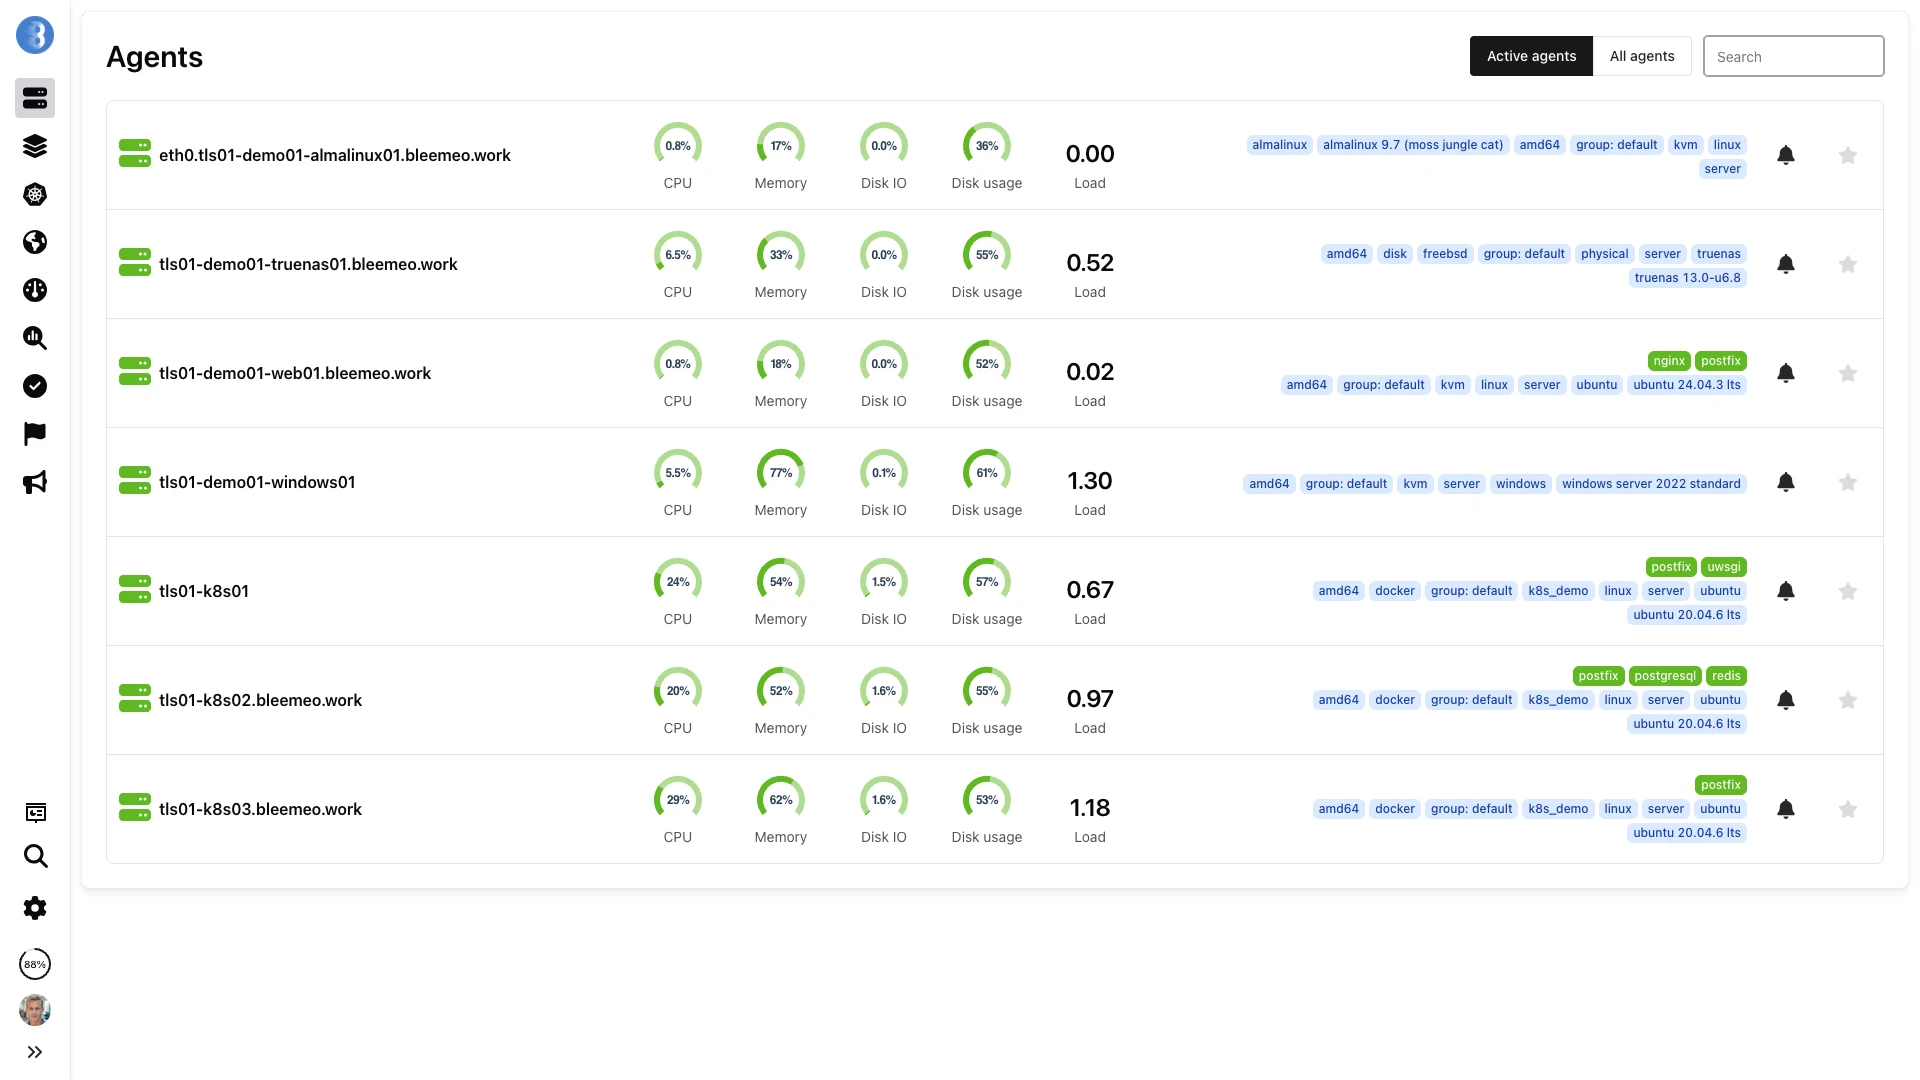
Des équipes qui livrent au lieu de surveiller leurs dashboards
Des startups SaaS aux PME, 500+ entreprises comptent sur Bleemeo pour garder leur production sous contrôle

Ce que disent nos clients
Ingénieurs et CTO font confiance à Bleemeo pour surveiller leur infrastructure
Nous avons besoin que nos équipes restent concentrées sur notre métier — l'affichage dynamique — plutôt que sur la surveillance d'infrastructure. Bleemeo supervise l'ensemble de notre environnement, du dédié à Azure, et libère nos équipes des alertes inutiles tout en garantissant notre qualité de service.
Le déploiement de Bleemeo a été incroyablement rapide. En environ une heure, nous l'avons déployé sur plus de 100 serveurs et avons immédiatement obtenu une visibilité complète sur notre infrastructure.
Nous avons déployé Bleemeo sur l'ensemble de notre infrastructure serveur en quelques heures seulement. Le monitoring de disponibilité nous alerte désormais instantanément dès qu'un service rencontre un problème.
Comparaison
Le construire, le payer trop cher, ou simplement l'utiliser
Construire sa propre stack, acheter une plateforme enterprise ou choisir la voie du milieu : voici ce que coûte vraiment chaque option, temps d'ingénierie compris.
Open Source DIY
Prometheus + Grafana + Alertmanager + Thanos + ... ou Zabbix, Nagios, Centreon, Checkmk- Semaines de mise en place et de réglage
- Maintenance et mises à jour continues
- Planification du stockage et gestion de capacité
- La haute disponibilité est votre problème
- Contrôle total sur tout
- Pas de coût de licence récurrent
Pertinent si vous avez déjà une équipe plateforme experte en monitoring, et du temps à y consacrer.
- Riche en fonctionnalités et puissant
- Infrastructure gérée
- Tarification complexe : une ligne séparée pour les hôtes, les logs, l'APM et les métriques personnalisées
- Des factures qui croissent plus vite que votre infrastructure
- Courbe d'apprentissage prononcée
- Souvent plus d'outil que nécessaire
Conçu pour les grandes entreprises avec de gros budgets et de grandes équipes.
Bleemeo
Monitoring clé en main pour les équipes en croissance- Prêt en production en 5 minutes
- Tarification simple par hôte, sans frais cachés
- Découverte automatique de 100+ technologies
- 13 mois de rétention inclus
- Compatible Prometheus et OpenTelemetry
- Entreprise européenne, résidence des données UE
Toute la visibilité dont vous avez besoin, sans la complexité inutile.
Ce que coûte vraiment l'auto-hébergement
Qui surveille le monitoring ?
Si votre serveur de monitoring tombe avec le reste, personne ne reçoit l'alerte. Bleemeo tourne en dehors de votre infrastructure.
Mises à jour et correctifs de sécurité
Prometheus, Grafana, Alertmanager et Thanos, ce sont quatre cycles de versions à suivre. Sur Bleemeo, aucun.
Haute disponibilité
Deux instances minimum pour ne pas perdre d'alertes pendant une maintenance.
Rétention
Prometheus garde 15 jours par défaut ; au-delà, il faut Thanos ou Mimir et un stockage objet. Bleemeo garde 13 mois en Professional.
Pour 50 serveurs sur 3 ans, notre calculateur compte 17 jours-ingénieur par an de maintenance à 450 € par jour, 14 jours d'installation et une paire en haute disponibilité : 39 397 € en auto-géré, contre 19 782 € avec Bleemeo Professional.
Faites votre calcul →Fondamentaux
Ce que votre équipe y gagne
Nous opérons toute la stack de monitoring — collecte, stockage, dashboards, alertes et rétention long terme — et le temps que votre équipe aurait passé sur Prometheus, Grafana, Alertmanager et Thanos retourne à votre produit.
Visibilité dès la première minute
Installez un seul agent et tout est découvert automatiquement. Pas d'exporters à configurer, pas de cibles de scrape à gérer, pas de tableaux de bord à construire de zéro. Glouton détecte les services via des sondes TCP et s'adapte quand votre stack change — sans redémarrage.
Une facture que vous pouvez anticiper
Tarification simple par hôte sans factures surprises. En Professional, chaque serveur inclut 1 000 métriques et 20 conteneurs ; les logs sont facturés à l'usage, au Gio, et les utilisateurs, tableaux de bord et alertes ne sont jamais facturés. Vous savez toujours ce que vous paierez.
Des alertes déjà réglées pour vous
Tableaux de bord pré-construits, règles d'alerte par défaut et 13 mois de rétention inclus. Une vraie visibilité en minutes, pas en semaines de configuration.
Rien à héberger, patcher ni mettre à jour
Oubliez la capacité de stockage, la fédération, la haute disponibilité et les mises à jour. On gère la plateforme — vous l'utilisez. Pas de base de données time series à régler, pas de politiques de rétention à configurer, pas de stratégie de sauvegarde à planifier pour vos données de monitoring.
Tout ce qu'on attend d'un monitoring, inclus
Les fondamentaux qu'un outil de monitoring doit maîtriser, réunis au même endroit, sans rien à installer de notre côté.
Collecter
- Serveurs Linux et Windows
- Docker et Kubernetes
- Équipements réseau SNMP
- VMware vSphere, AWS et Azure
- 100+ intégrations, exporters Prometheus, OTLP
- Checks personnalisés, dont les plugins Nagios
Visualiser
- Dashboards temps réel et modèles
- 13 mois de rétention (Professional)
- Recherche dans les logs
- Checks uptime depuis 7 localisations, expiration SSL et domaine
- Pages de statut publiques
Alerter
- Seuils par défaut prêts à l'emploi
- Règles d'alerte PromQL
- Slack, Teams, PagerDuty, Opsgenie, ilert, e-mail, SMS, webhooks
- Astreintes et escalade
- Silences pour les maintenances
- Apps iOS et Android
Administrer
- Utilisateurs, rôles et 2FA
- Journal d'audit
- API REST
- Serveur MCP
- Rapport hebdomadaire
Monitoring de serveurs
Un monitoring serveur qui s'installe tout seul
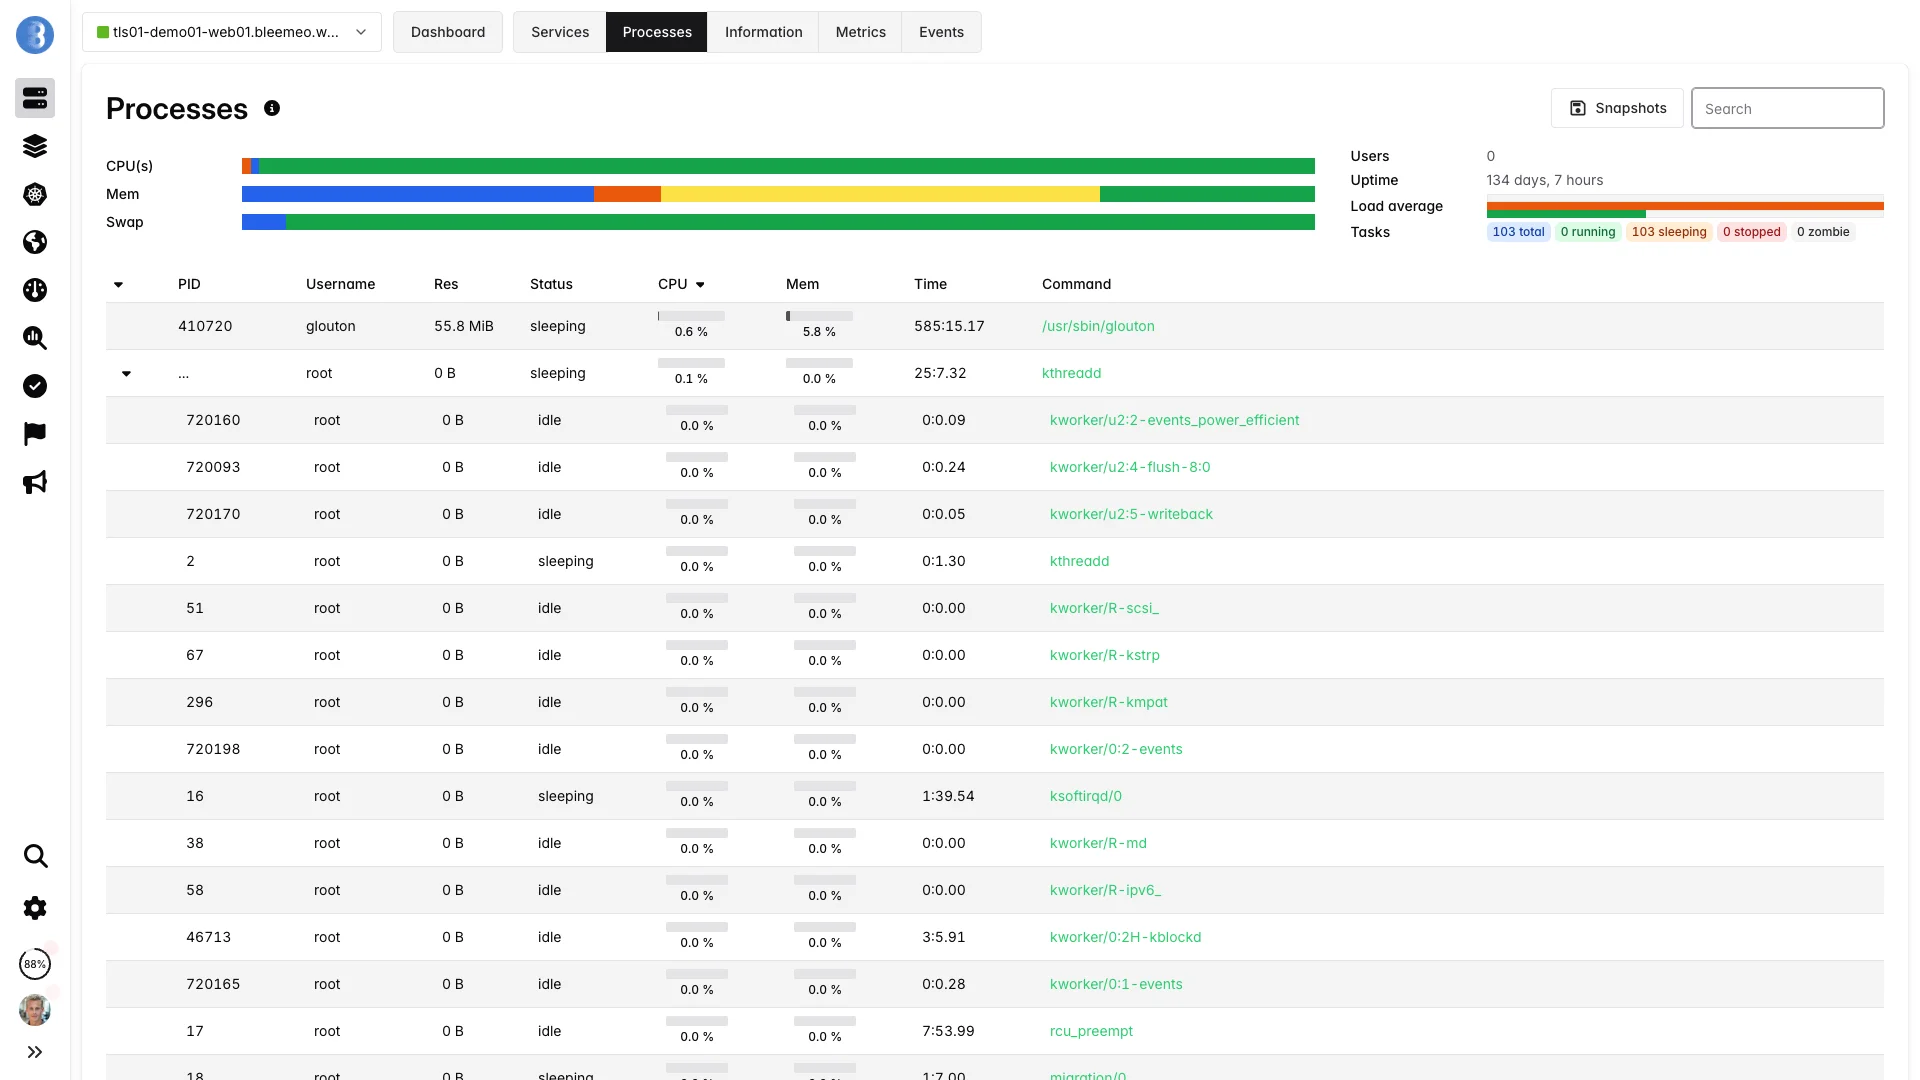
La plupart des outils de monitoring exigent que vous définissiez quoi surveiller, écriviez des fichiers de config et construisiez des tableaux de bord avant de voir une seule métrique. Avec Bleemeo, vous installez un agent léger et il fait le reste.
Glouton, notre agent open-source, découvre automatiquement chaque service en cours — bases de données, serveurs web, files d'attente, conteneurs — et commence à collecter des métriques à une résolution de 10 secondes. Les tableaux de bord et alertes sont prêts avant même que vous ayez fini votre café.
Couverture
De 5 à 500 serveurs, un seul outil
Surveillance complète pour chaque partie de votre infrastructure
Surveillance des serveurs
Serveurs physiques et virtuels, VMs et infrastructure bare-metal. Surveillez les métriques système, processus et services.
Explorer le monitoring de serveurs →Surveillance Kubernetes
Observabilité complète de Kubernetes. Surveillez clusters, nodes, pods et services avec découverte automatique.
Explorer le monitoring Kubernetes →Surveillance des applications
Surveillez bases de données, serveurs web, files de messages et applications personnalisées. Suivez performance et disponibilité.
Découvrir le monitoring d'applications →Surveillance des conteneurs
Métriques Docker et conteneurs. Surveillez l'utilisation des ressources, la santé et la performance de votre flotte de conteneurs.
Découvrir le monitoring des conteneurs Docker →Surveillance réseau
Suivez la performance réseau, l'utilisation de la bande passante et la connectivité. Surveillez switchs, routeurs et load balancers.
Explorer le monitoring réseau →Surveillance cloud
AWS, Azure, GCP et environnements multi-cloud. Visibilité unifiée sur toute votre infrastructure cloud.
Découvrir le monitoring AWS →Gestion des logs
Les logs à côté de vos métriques, facturés au Gio
Chez la plupart des éditeurs de monitoring, les logs sont un produit séparé nécessitant une infrastructure dédiée. Avec Bleemeo, la collecte de logs est intégrée dans le même agent que vous utilisez déjà — pas de stack ELK à déployer, pas de Loki à configurer. Vous ne payez que ce que vous ingérez à 0,50€/Gio, sans frais d'indexation cachés ni surcoûts de rétention.
Prometheus
Vous aimez Prometheus ? Laissez tomber l'ops.
Prometheus est puissant — et le faire tourner en production, c'est s'occuper du stockage, de la rétention, de la fédération, de la haute disponibilité et d'une constellation d'exporters.
Bleemeo vous offre une compatibilité PromQL complète avec un stockage long terme géré et 13 mois de rétention. Gardez le langage de requête que vous connaissez, abandonnez le fardeau infrastructure.
scrape_configs:
  - job_name: 'nodes'
    static_configs:
      - targets:
        - 'node1:9100'
        - 'node2:9100'

  - job_name: 'kubernetes'
    kubernetes_sd_configs:
- role: podOpenTelemetry
Gardez votre instrumentation. Partez quand vous voulez.
Vous utilisez déjà OpenTelemetry ou des exporters Prometheus ? Bleemeo accepte vos métriques et logs tels quels. Pas d'agents propriétaires, pas de SDK spécifiques. Votre instrumentation reste portable — on lui donne juste un foyer.
IA & ML
Alerté plus tôt, réveillé moins souvent
Les petites équipes ne peuvent pas se permettre de courir après de fausses alertes. Bleemeo apprend le rythme quotidien et hebdomadaire du CPU, de la mémoire et du swap de chaque serveur et signale les heures qui sortent de la plage attendue — sans aucun seuil à configurer et sans réveiller personne. Un second modèle répond à l'autre question : non pas « est-ce normal en ce moment ? », mais « quand est-ce que ça manque ? »
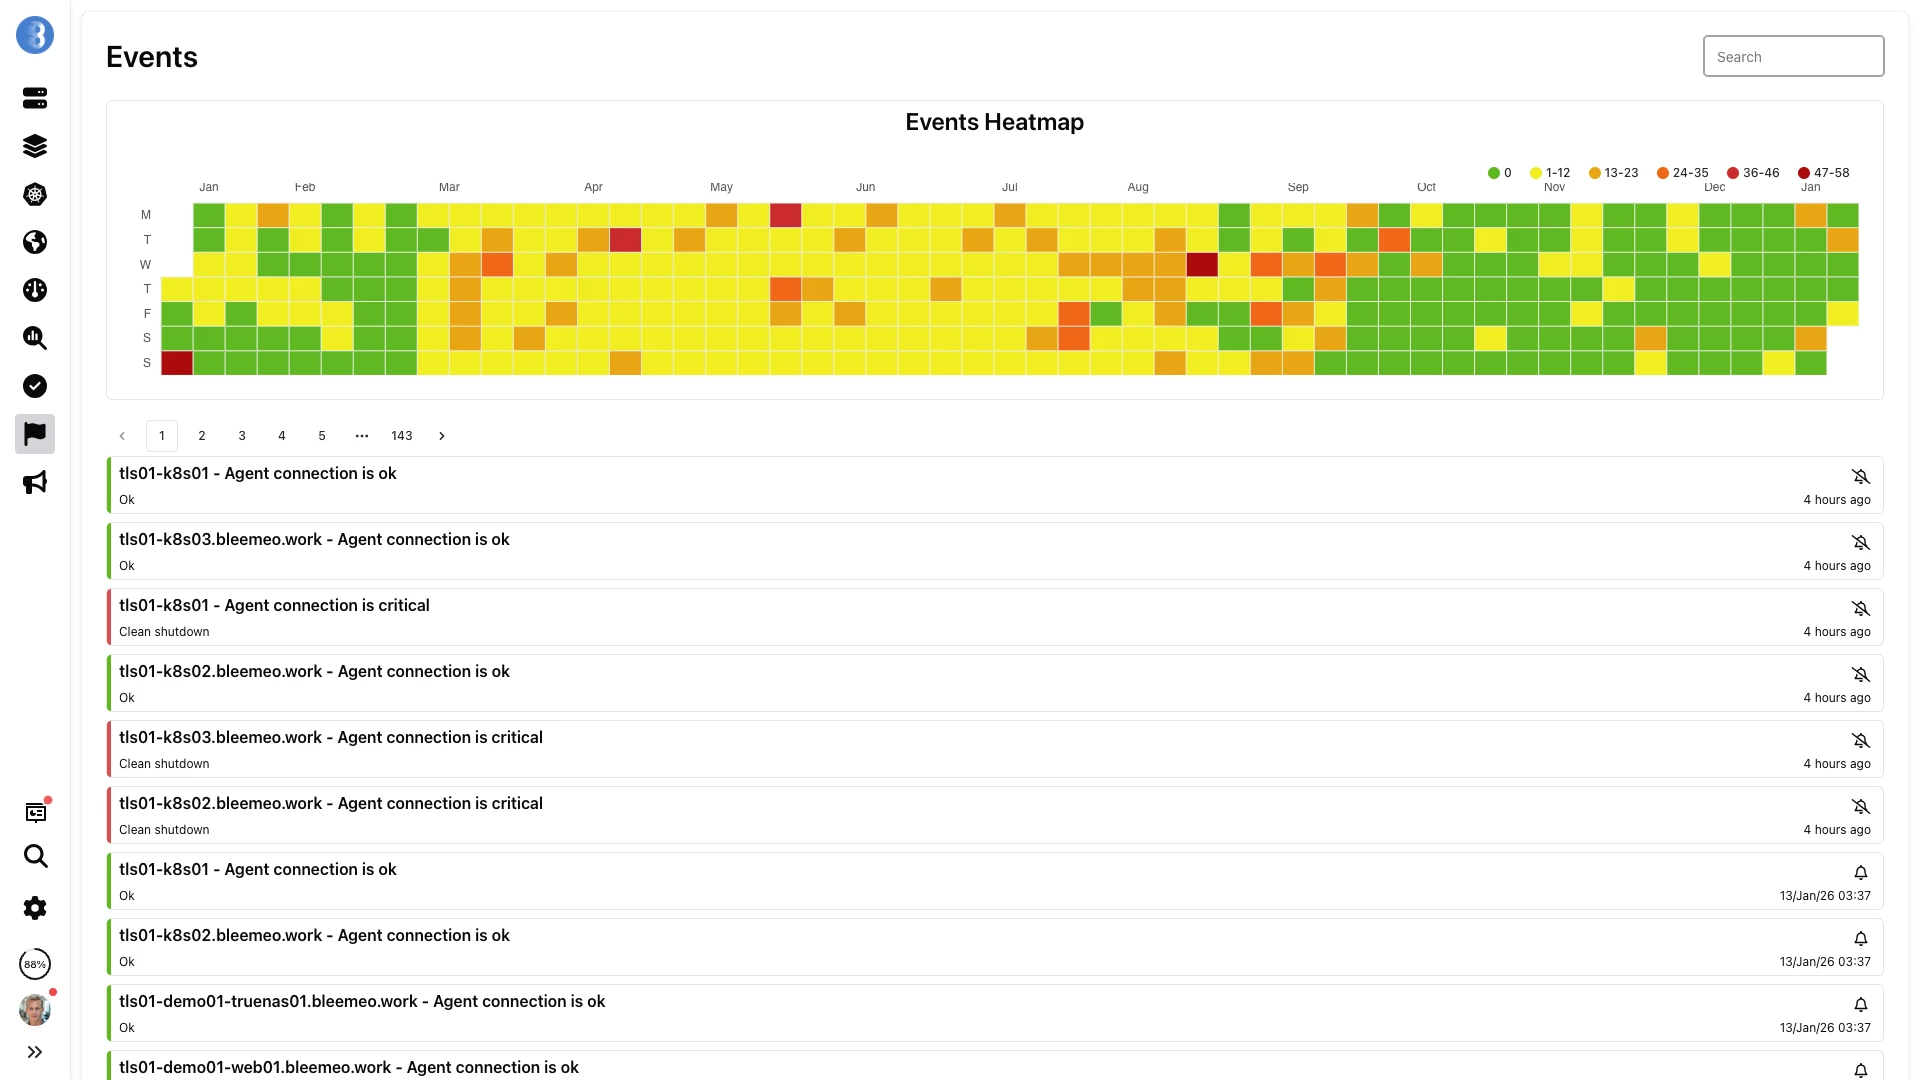
Une année d'événements d'un coup d'œil — le même historique que les modèles lisent pour apprendre à quoi ressemble une semaine normale.
Détection d'anomalies
Bleemeo apprend le rythme quotidien et hebdomadaire du CPU, de la mémoire et du swap de chaque serveur sur les deux dernières semaines et signale les heures qui sortent de la plage attendue. Rien à configurer, et cela ne vous réveille jamais : une anomalie est un signal, pas une sévérité.
Prévision de capacité
Les tendances disque, mémoire et swap sont projetées vers une date, pas un pourcentage : « ce volume atteint 90 % le 3 avril ». Une date n'est annoncée que si la dérive s'est confirmée sur deux fenêtres — un service qui démarre et prend la moitié de la RAM n'est pas une fuite.
Temps d'avance mesuré
Chaque anomalie est rapprochée de la première alerte qui l'a suivie sur le même hôte : l'interface affiche l'écart réel — « alerte 42 minutes plus tard » — et le délai médian par vue. Vous voyez ce que vaut la détection sur votre propre infrastructure.
Elle apprend de vos réponses
Chaque anomalie attend un oui ou un non. Les fausses alertes répétées mettent d'elles-mêmes la détection en pause sur cette métrique : un signal bruyant se tait, au lieu d'apprendre à votre équipe à ignorer la fonctionnalité.
Suggestions de réduction du bruit Beta
Bleemeo regroupe vos alertes récurrentes et propose le silence ou la configuration flappy qui les ferait taire, pré-rempli et à un clic. Cherchez dans votre historique d'événements par le sens plutôt que par les mots exacts, et demandez si quelque chose de semblable a déjà été vu.
Serveur MCP pour assistants IA
Connectez Claude, Cursor ou VS Code via notre serveur Model Context Protocol. Plus de 30 outils en lecture seule permettent à un assistant de répondre sur la santé de votre infrastructure — il peut tout lire et ne rien modifier.
Sécurité
Vos données de monitoring sont la carte de votre infrastructure. Nous les protégeons en conséquence.
La sécurité n'est ni un module complémentaire ni une fonctionnalité réservée à l'offre entreprise — elle est intégrée à chaque couche de la plateforme, de l'agent qui tourne sur vos serveurs au stockage où sont conservés vos métriques et logs.
Chaque agent s'authentifie auprès du cloud Bleemeo avec des identifiants uniques liés à votre compte. Il n'y a pas de flux de données anonymes ni de endpoints partagés — chaque source de métriques est vérifiée avant qu'un seul point de donnée ne soit accepté. Vous savez toujours exactement ce qui remonte dans votre compte, et rien d'non autorisé ne peut injecter de fausses données dans vos tableaux de bord.
- Chiffrement TLS 1.3 pour toutes les données en transit
- Chiffrement AES-256 pour toutes les données au repos
- Authentification par agent avec identifiants uniques
- Contrôle d'accès par rôle et journalisation d'audit
Européen
Une entreprise européenne, pas seulement une région européenne
N'importe quel fournisseur peut louer une baie à Francfort. Moins nombreux sont ceux qui vous disent avec quelle société vous contractez, sous quel droit, et ce qui quitte exactement vos serveurs.
Vous contractez avec une société française
Bleemeo est une société française, fondée à Toulouse en 2015 et dirigée depuis Toulouse. Vous êtes facturé en euros, sous droit français, avec un délégué à la protection des données réellement joignable et un support dans votre fuseau horaire — pas une entité américaine avec une filiale européenne accolée.
Vos métriques restent en région parisienne
Les métriques et les logs sont stockés dans l'Union européenne, en région parisienne. Une région, une juridiction, nommée — plutôt que les « centres de données européens » que tout le monde écrit. La liste complète des sous-traitants, y compris les quelques-uns hors UE encadrés par des clauses contractuelles types, est sur la page sécurité.
Aucune boîte noire sur vos serveurs
Glouton, l'agent que vous installez, est open source sous licence Apache 2.0. Ce qu'il collecte et ce qu'il envoie se lit ligne à ligne. Pour qui doit justifier un fournisseur, c'est une garantie plus solide qu'un badge de résidence.
Page de statut publique
Montrez à vos clients la disponibilité que vous assurez
Les mêmes checks qui alertent votre équipe alimentent une page de statut publique sur votre propre domaine : santé des services en temps réel, incidents en cours et historique de disponibilité. Une URL que votre support partage pendant un incident — sans outil de status page à acheter en plus, sans mise à jour manuelle.
Découvrir le monitoring de disponibilité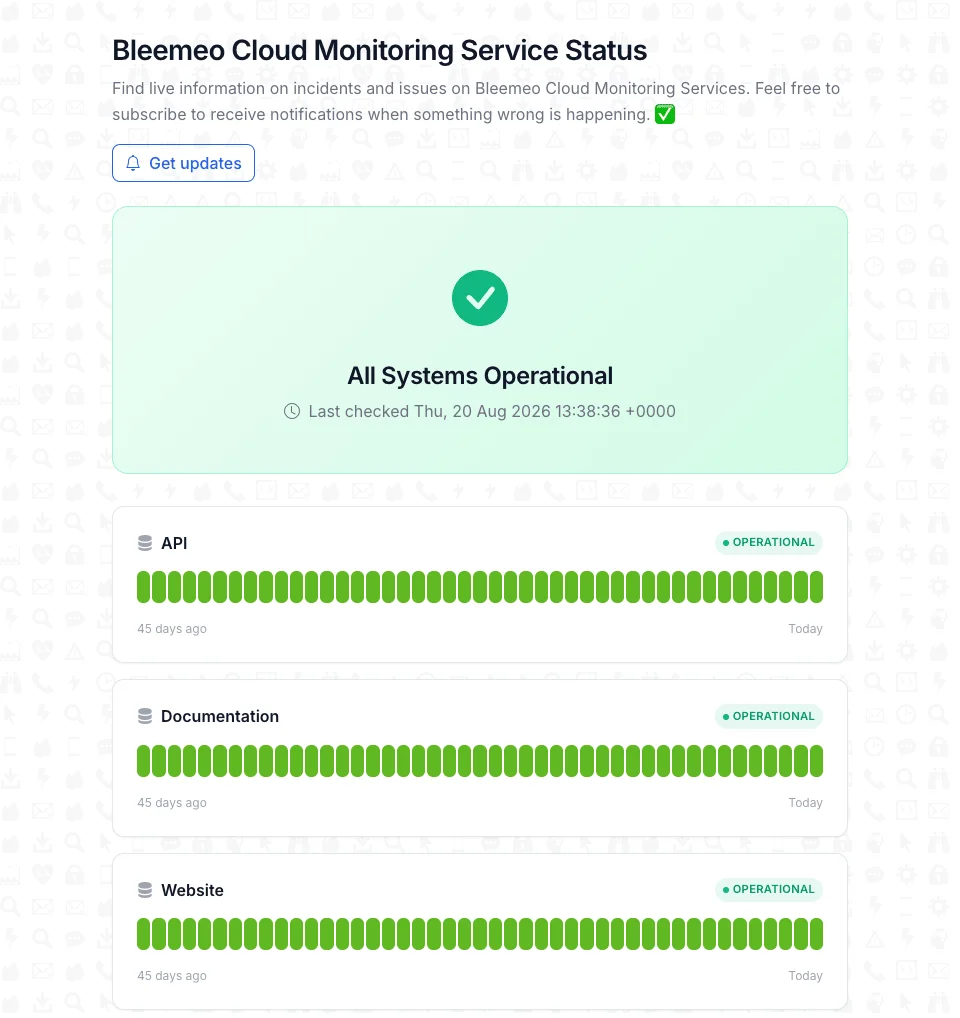
C'est la page de statut de Bleemeo elle-même — consultez-la en direct.
Questions fréquemment posées
Tout ce que vous devez savoir sur la plateforme de surveillance Bleemeo
Comment fonctionne votre plateforme de surveillance ?
Bleemeo utilise un agent open-source léger appelé Glouton que vous installez sur vos serveurs, VMs ou clusters Kubernetes. L'agent découvre automatiquement les services et applications en cours d'exécution, collecte les métriques système toutes les 10 secondes et transmet les données de manière sécurisée vers notre plateforme cloud. De là, vous obtenez des tableaux de bord en temps réel, des alertes intelligentes et 13 mois de rétention des métriques. Pour les services cloud, nous nous intégrons directement avec AWS CloudWatch et Azure Monitor. La plateforme accepte également les données via le protocole OpenTelemetry (OTLP).
Quels types d'infrastructure et d'applications supportez-vous ?
Bleemeo supporte plus de 100 technologies prêtes à l'emploi avec découverte automatique. Cela inclut : Systèmes d'exploitation (Linux, Windows), Conteneurs (Docker, containerd, Kubernetes), Bases de données (MySQL, PostgreSQL, MongoDB, Redis, Elasticsearch), Serveurs web (Apache, Nginx, HAProxy), Files de messages (RabbitMQ, Kafka), Plateformes cloud (AWS, Azure, GCP) et Équipements réseau via SNMP (Cisco, Ubiquiti, Dell). Nous supportons également les métriques personnalisées via StatsD, les exporters Prometheus et l'instrumentation OpenTelemetry.
Comment vous intégrez-vous avec ma stack existante ?
Bleemeo offre plusieurs chemins d'intégration : installez notre agent Glouton pour la surveillance d'infrastructure sans configuration, envoyez des métriques via OpenTelemetry (OTLP), ou connectez vos comptes cloud via des intégrations natives. Pour les notifications, nous nous intégrons avec Slack, PagerDuty, OpsGenie, Microsoft Teams, email, SMS et webhooks personnalisés. Aucune modification de code n'est requise pour la surveillance d'infrastructure - installez simplement l'agent et les services sont découverts automatiquement.
Votre surveillance impacte-t-elle les performances du système ?
Non. Glouton est extrêmement léger — typiquement moins de 1% de CPU et moins de 100 Mo de mémoire. L'agent collecte les métriques de manière asynchrone et groupe les transmissions pour minimiser la charge réseau, il ne concurrence jamais vos charges de production.
Comment assurez-vous la sécurité et la confidentialité des données ?
La sécurité est fondamentale pour notre plateforme : toutes les données sont chiffrées en transit avec TLS 1.3 et au repos avec AES-256, et stockées dans l'UE (région de Paris) conformément au RGPD. L'agent collecte les métriques système et des services — ainsi que vos logs si vous utilisez la gestion des logs — et comme Glouton est open source, vous pouvez vérifier exactement ce qui quitte vos serveurs. Chaque agent s'authentifie avec ses propres identifiants via des connexions avec certificate pinning, et l'accès est protégé par des permissions basées sur les rôles et une journalisation d'audit. Notre infrastructure fait l'objet d'audits de sécurité réguliers.
Supportez-vous les métriques et les logs ?
Oui, Bleemeo supporte les métriques et les logs. Les métriques sont collectées toutes les 10 secondes avec 13 mois de rétention. Les logs peuvent être collectés et centralisés via notre agent avec recherche en temps réel, filtrage et alertes. Les deux types de données peuvent être corrélés dans nos tableaux de bord pour un dépannage complet.
Combien de temps faut-il pour démarrer avec votre solution ?
Vous pouvez être opérationnel en moins de 5 minutes. Installez l'agent Glouton avec une seule commande — one-liner pour Linux, installeur pour Windows, ou chart Helm pour Kubernetes. L'agent découvre automatiquement vos services et remplit les tableaux de bord immédiatement.
Qu'est-ce qui différencie votre plateforme des autres outils de surveillance ?
Bleemeo se distingue par : Simplicité - la découverte automatique signifie pas de configuration manuelle de ce qu'il faut surveiller. Agent open-source - Glouton est entièrement open-source, pas de boîte noire. Tarification prévisible - tarification par hôte sans frais cachés sur les métriques ou le volume de données. Longue rétention - 13 mois inclus, pas 15 jours. Entreprise européenne - résidence des données UE et approche RGPD-first. Basé sur les standards - support natif Prometheus et OpenTelemetry signifie pas de vendor lock-in.
Supportez-vous OpenTelemetry et Prometheus ?
Oui. Bleemeo supporte les deux standards nativement. Pour Prometheus, notre agent scrape vos exporters existants et PromQL fonctionne sans configuration. Pour OpenTelemetry, envoyez métriques et logs via OTLP (gRPC ou HTTP) — aucun changement d'instrumentation requis.
Votre solution est-elle adaptée aux environnements cloud-native et hybrides ?
Oui, Bleemeo est conçu pour l'infrastructure moderne. Pour le cloud-native : nous supportons Kubernetes avec une visibilité complète sur les clusters, noeuds, pods et conteneurs via un déploiement Helm. La découverte automatique gère les workloads éphémères automatiquement. Pour les environnements hybrides : surveillez les serveurs on-premise, VMs cloud, conteneurs et services managés depuis une seule plateforme. Notre agent fonctionne de manière identique dans tous les environnements, et les tableaux de bord peuvent combiner les métriques de toutes les sources pour une visibilité unifiée.
Derniers articles du blog
Conseils, tutoriels et bonnes pratiques pour la surveillance d'infrastructure

Une fiabilité démontrable. Des coûts prévisibles.
Prêt en production en 5 minutes — avec l'historique de disponibilité à présenter à votre direction et une tarification par serveur pour planifier votre budget.
Essai gratuitAucune carte bancaire requise • 15 jours d'essai gratuit • Accès complet aux fonctionnalités