Construit sur Prometheus & OpenTelemetry
Sans verrouillage fournisseur
Nagios a été un pionnier du monitoring dans les années 2000, mais son architecture basée sur les plugins et ses fichiers de configuration manuels n'ont pas suivi l'évolution de l'infrastructure moderne. Bleemeo vous offre la découverte automatique, des tableaux de bord intégrés et des alertes aux seuils par défaut pertinents — sans plugins, sans NRPE, sans objects.cfg.
Essai gratuit 15 joursSans carte bancaireSans engagement
Sans verrouillage fournisseur
Stockées dans l'UE (région de Paris) · Conforme RGPD
À travers l'Europe et au-delà
Plus de 500 équipes quittent les déploiements Nagios historiques
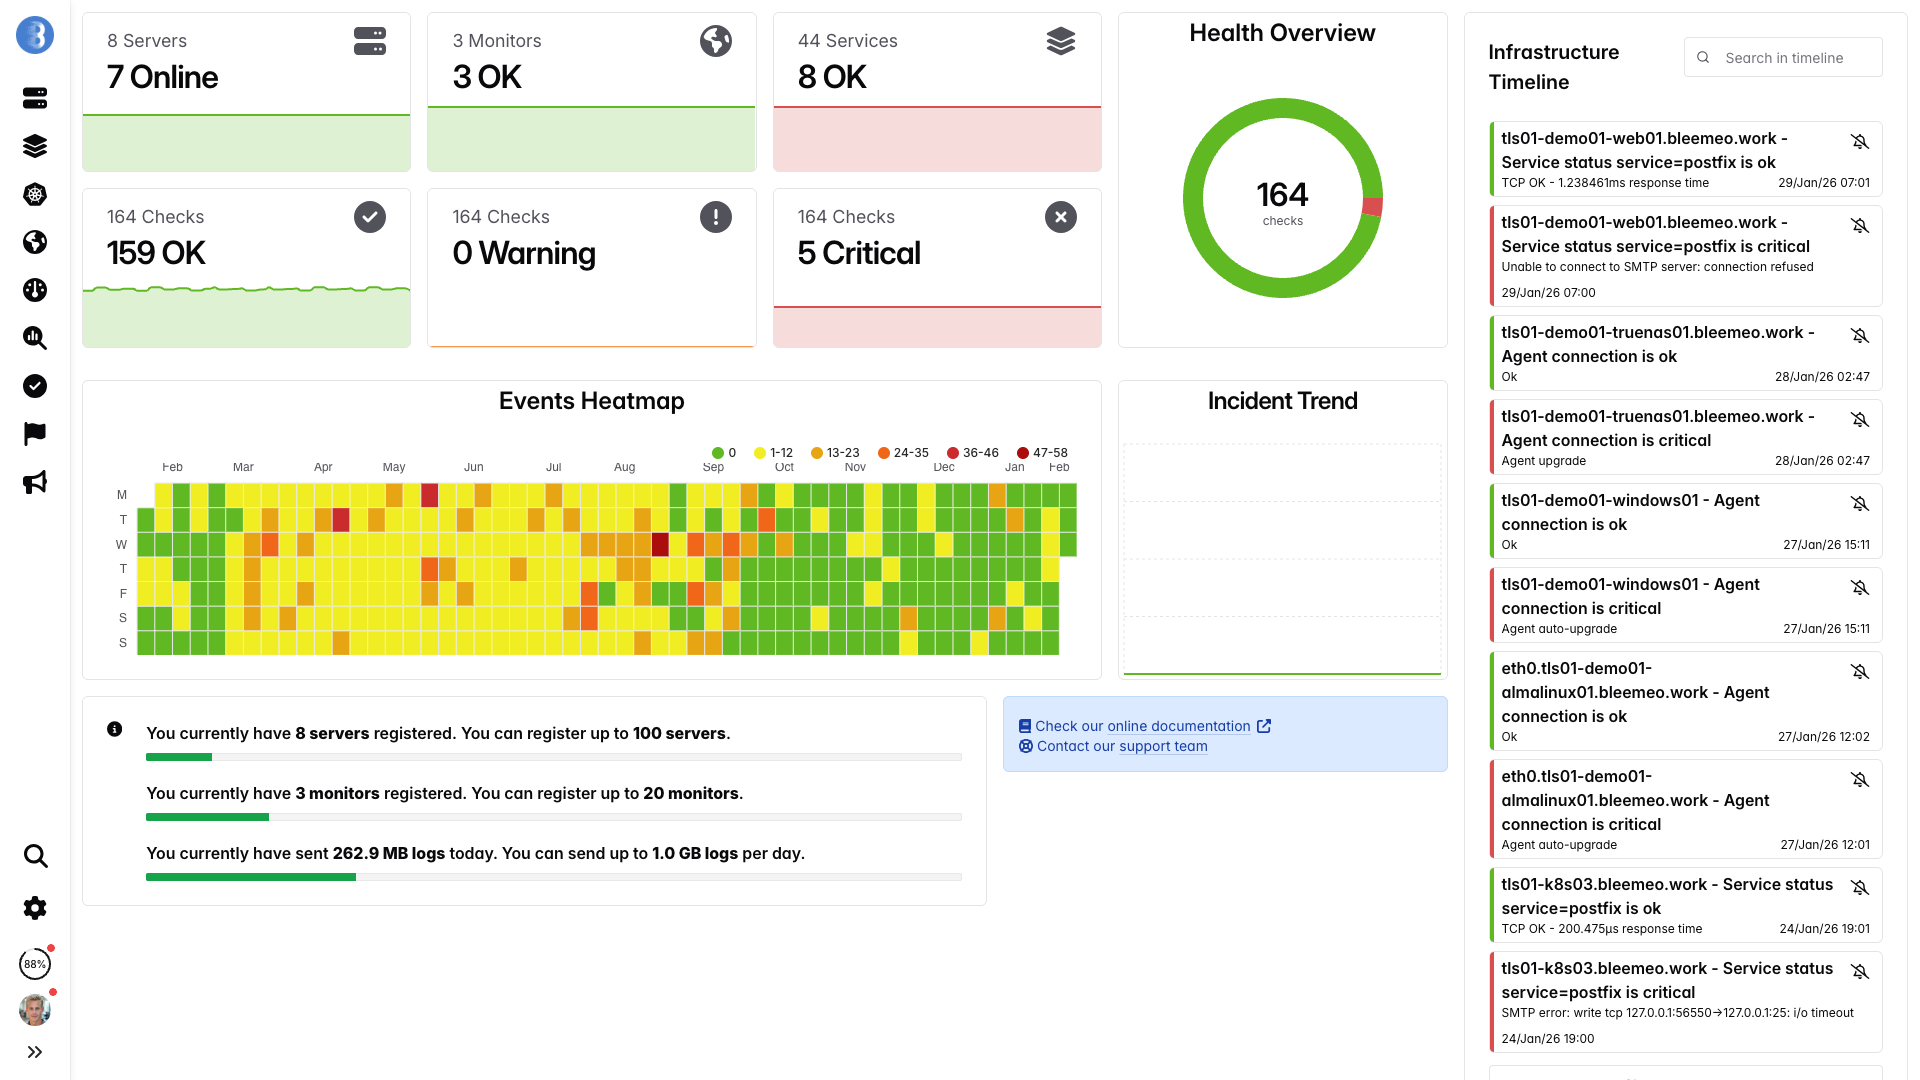
Tableaux de bord en temps réel, prêts en quelques minutes — aucune configuration nécessaire
Agent installé en 30 secondes, premiers dashboards en 5 minutes — sans fichiers .cfg ni rollout NRPE
Une commande, aucune configuration — les métriques arrivent en moins d'une minute.
Pourquoi changer
Configurer Nagios nécessite d'éditer des fichiers texte complexes tels que hosts.cfg, services.cfg et commands.cfg, puis de recharger le daemon pour chaque modification. Chaque nouvel hôte ou service doit être défini manuellement avec des commandes de vérification, des intervalles, des périodes de notification, des groupes de contacts et des seuils — souvent sur des dizaines de lignes par objet. Une seule erreur de syntaxe dans ces définitions peut empêcher le daemon Nagios de redémarrer, laissant votre monitoring aveugle jusqu'à ce que le problème soit trouvé et corrigé. Ce qui prend des jours voire des semaines avec Nagios ne prend que quelques minutes avec la découverte automatique de Bleemeo, qui détecte les services, conteneurs et composants d'infrastructure dès l'installation de l'agent.
Faire fonctionner Nagios signifie que vous êtes responsable du serveur de monitoring lui-même : correctifs OS, mises à jour Apache ou PHP, compatibilité des plugins, espace disque pour la rétention des données de performance, et mises à jour des agents NRPE sur chaque serveur de votre parc. Chaque agent NRPE doit être configuré individuellement avec les commandes de vérification autorisées et les règles de pare-feu, créant une surface de maintenance qui croît linéairement avec votre infrastructure. La communauté Nagios s'est fragmentée en forks concurrents comme Icinga 2, Naemon et Shinken, rendant plus difficile de trouver des plugins à jour, des add-ons compatibles et une documentation fiable. Bleemeo est une plateforme SaaS entièrement gérée — pas de serveurs à patcher, pas d'agents à configurer manuellement, pas de dépôts de plugins à auditer — pour que votre équipe puisse se concentrer sur la résolution des incidents plutôt que sur la maintenance de la stack de monitoring.
Nagios a été conçu pour des datacenters on-premises statiques où les hôtes changent rarement et les adresses IP sont fixes. Il n'a aucun support natif pour les conteneurs, les pods Kubernetes, les groupes d'auto-scaling ou les fonctions serverless. Chaque fois qu'une instance cloud est ajoutée ou supprimée, la définition d'hôte correspondante doit être ajoutée ou retirée manuellement — ou via des scripts externes fragiles — entraînant des alertes obsolètes, une dérive de configuration et des notifications fantômes pour des hôtes qui n'existent plus. Bleemeo a été construit dès le premier jour pour les environnements éphémères et cloud-natifs où l'infrastructure change constamment.
L'interface web par défaut de Nagios — connue sous le nom d'interface CGI — n'a pratiquement pas changé depuis plus d'une décennie. Elle offre uniquement des tableaux basiques d'état des hôtes et services sans tableaux de bord en temps réel, graphiques interactifs de séries temporelles ou responsive mobile. La plupart des équipes finissent par installer des frontends tiers comme Thruk, Adagios, ou ajoutent Grafana avec PNP4Nagios juste pour obtenir des visualisations utilisables, ajoutant encore plus de composants à maintenir et sécuriser. Bleemeo fournit des tableaux de bord modernes et personnalisables avec du streaming de métriques en temps réel et des applications natives iOS et Android, sans avoir besoin d'assembler plusieurs outils pour une visibilité basique.
Pendant une courte pause déjeuner, nous avons installé Bleemeo, créé une métrique personnalisée, testé les alertes et étions prêts pour la production. La rapidité de déploiement est remarquable.
Comparatif
| Feature | Nagios | Bleemeo |
|---|---|---|
| Temps d'Installation | Des jours à des semaines de définitions manuelles d'hôtes et services | Quelques minutes avec une seule commande d'installation d'agent |
| Configuration | Édition manuelle d'objects.cfg, commands.cfg et contacts.cfg | Découverte automatique des services, conteneurs et infrastructure |
| Cloud-Native | Pas de support conteneurs ni Kubernetes ; modèle d'hôtes statiques uniquement | Intégration native Kubernetes, Docker et fournisseurs cloud |
| Applications Mobiles | Aucune application mobile officielle disponible | Applications natives iOS et Android avec notifications push |
| Alertes | Notifications email et pager basiques via scripts personnalisés | Routage intelligent avec SMS, Slack, Teams, PagerDuty et webhooks |
| Maintenance | Serveur auto-hébergé nécessitant correctifs OS, mises à jour de plugins et gestion NRPE | Plateforme SaaS entièrement gérée sans maintenance serveur |
| Tableaux de Bord | Interface intégrée datée ; nécessite Thruk ou Grafana pour des tableaux de bord utilisables | Tableaux de bord modernes et personnalisables |
| Gestion des Logs | Non inclus ; nécessite une stack ELK ou Graylog séparée | Collecte, recherche et analyse de logs intégrées dans la même plateforme |
| Détection d'Anomalies | Seuils statiques uniquement ; pas de machine learning ni d'analyse de tendances | Détection d'anomalies par ML avec apprentissage automatique des baselines |
| Prometheus & OpenTelemetry | Pas de support natif ; architecture de checks incompatible | Scraping natif des exporteurs Prometheus et support OpenTelemetry |
| Scalabilité | Architecture mono-serveur ; les déploiements distribués nécessitent des add-ons complexes comme Mod Gearman ou DNX | SaaS cloud-natif qui scale automatiquement de 10 à plus de 10 000 agents |
| API | Interface de commandes externes limitée via pipe ; pas d'API REST dans Core | API REST complète pour automatisation, intégration et workflows personnalisés |
| Monitoring de Disponibilité | Plugin check_http basique ; pas de sondage multi-locations ni de rapports SLA | Vérifications de disponibilité globales depuis plusieurs emplacements avec tableaux de bord SLA |
| Tarification | Core est gratuit ; Nagios XI Standard est affiché à 2 595 $ (prix catalogue) pour 100 nœuds, plus 2 104 $ par an de maintenance, en plus de l'infrastructure et du temps sysadmin | 10,99 EUR/mois par serveur, avec 1 000 métriques, 20 conteneurs et un check de disponibilité inclus (au moins 5 par compte) ; logs à 0,50 EUR/Gio |
Les fondamentaux qu'un outil de monitoring doit maîtriser, réunis au même endroit, sans rien à installer de notre côté.
Coûts
Nagios Core est open source, mais une stack de production coûte une licence, un serveur et le temps d'ingénierie pour la faire tourner. Voici la comparaison pour 50 serveurs sur 3 ans, avec Nagios XI à son prix catalogue publié.
Scénario : 50 serveurs sur 3 ans, déploiement cloud. Temps d’ingénierie à 450 € par jour — le même modèle que notre calculateur de coûts, où vous pouvez saisir vos propres chiffres. Prix publics vérifiés le 4 octobre 2026 ; dollars convertis à 0,91.
Le détail ci-dessus repose sur 50 serveurs sur 3 ans. Le calculateur vous permet d'utiliser vos propres chiffres, nombre de serveurs et add-ons compris, pour estimer vos économies en remplaçant Nagios par Bleemeo.
Avantages
Installez notre agent léger et il découvre automatiquement les services comme MySQL, PostgreSQL, Redis, Nginx, Apache, les conteneurs Docker et les pods Kubernetes. Il n'y a aucun fichier de configuration à écrire, aucune commande de vérification à définir et aucun rechargement de daemon à effectuer. Les nouveaux services sont détectés et surveillés en quelques secondes après leur apparition sur l'hôte, éliminant les définitions manuelles d'objets qui consomment tant de temps avec Nagios.
Construite de zéro pour une infrastructure moderne et dynamique. Bleemeo supporte nativement les clusters Kubernetes, les runtimes Docker et containerd, les instances AWS, Azure et GCP. Les charges de travail éphémères qui montent et descendent en charge sont suivies automatiquement — pas de définitions d'hôtes obsolètes, pas d'alertes fantômes et pas de scripts de nettoyage manuels nécessaires.
Chaque service découvert est livré avec des seuils par défaut pertinents : les alertes fonctionnent dès le premier jour sans écrire un seul check. L'escalade, les plannings d'astreinte et le routage flexible des notifications envoient les alertes à la bonne équipe via Slack, Microsoft Teams, PagerDuty, SMS ou webhooks, tandis que la détection d'anomalies par ML apporte du contexte sans jamais déclencher d'astreinte — prévenant la fatigue d'alerte qui affecte les déploiements Nagios.
Des tableaux de bord modernes et responsives avec streaming de métriques en temps réel offrent une visibilité instantanée sur l'ensemble de votre infrastructure. Créez des vues personnalisées en minutes avec des widgets glisser-déposer, des graphiques interactifs de séries temporelles et des cartes de topologie. Contrairement à Nagios, il n'est pas nécessaire d'installer Thruk, Grafana ou PNP4Nagios pour obtenir des visualisations utilisables.
Les applications natives iOS et Android vous permettent de surveiller toute votre infrastructure et de réagir aux incidents où que vous soyez. Recevez des notifications push dès qu'un problème est détecté, acquittez les alertes, consultez les tableaux de bord et explorez les détails des métriques — le tout depuis votre téléphone ou tablette, sans VPN nécessaire pour accéder à un serveur Nagios on-premises.
Métriques, logs, monitoring de disponibilité et détection d'anomalies sont unifiés dans une seule plateforme. Avec Nagios, les équipes assemblent généralement des outils séparés pour la gestion des logs (ELK ou Graylog), les tableaux de bord (Grafana) et les vérifications de disponibilité (services externes), créant une stack fragmentée coûteuse à exploiter et difficile à corréler. Bleemeo rassemble tout pour que vous puissiez aller de l'alerte à la cause racine dans une seule interface.
Migration
Créez votre compte Bleemeo gratuit et installez l'agent léger sur chaque serveur avec une seule commande. L'agent supporte Debian, Ubuntu, RHEL, CentOS, Alpine et la plupart des distributions Linux majeures. L'installation prend moins d'une minute par hôte :
wget -qO- 'https://get.bleemeo.com?accountId=...'Dans les secondes suivant l'installation, l'agent découvre automatiquement les services en cours d'exécution tels que MySQL, PostgreSQL, Redis, Nginx, Apache, Elasticsearch, les conteneurs Docker et les pods Kubernetes. Connectez-vous au tableau de bord Bleemeo pour vérifier que tous vos services critiques sont détectés et que les métriques remontent. Pour toute application personnalisée, vous pouvez ajouter des endpoints compatibles Prometheus ou des vérifications personnalisées en quelques minutes.
Configurez les canaux de notification — Slack, Microsoft Teams, PagerDuty, SMS, email ou webhooks — via l'interface web intuitive. Bleemeo est livré avec des seuils par défaut pertinents pour tous les services découverts, vous obtenez donc des alertes significatives dès le départ. Personnalisez les seuils et les règles de routage pour correspondre à la structure d'astreinte et aux politiques d'escalade de votre équipe sans éditer un seul fichier de configuration.
Créez des tableaux de bord personnalisés pour reproduire et améliorer les vues que vous aviez dans Nagios, Thruk ou Grafana. Le constructeur de tableaux de bord de Bleemeo vous permet de glisser-déposer des widgets pour le CPU, la mémoire, le disque, le réseau et les métriques spécifiques aux applications. Partagez les tableaux de bord avec votre équipe ou affichez-les sur des écrans muraux pour une conscience opérationnelle en temps réel.
Gardez Nagios en fonctionnement à côté de Bleemeo pendant une à deux semaines pour valider la couverture, la précision des alertes et les workflows de l'équipe. Comparez les alertes générées par les deux systèmes pour vous assurer que Bleemeo détecte tout ce que Nagios fait — et plus, grâce à la découverte automatique et à la détection d'anomalies. Cette période parallèle donne aussi à votre équipe le temps de se familiariser avec la nouvelle interface et les applications mobiles.
Une fois votre équipe confiante dans la couverture et les alertes de Bleemeo, faites-en votre plateforme de monitoring principale et désactivez Nagios. Supprimez le serveur Nagios, désinstallez les agents NRPE de vos hôtes et retirez l'infrastructure associée. Vous libérerez immédiatement du temps sysadmin précédemment consacré à la maintenance des plugins, la gestion des fichiers de configuration et l'entretien du serveur Nagios.
Ingénieurs et CTO font confiance à Bleemeo pour surveiller leur infrastructure
Nous avons besoin que nos équipes restent concentrées sur notre métier — l'affichage dynamique — plutôt que sur la surveillance d'infrastructure. Bleemeo supervise l'ensemble de notre environnement, du dédié à Azure, et libère nos équipes des alertes inutiles tout en garantissant notre qualité de service.
Bleemeo nous accompagne depuis des années : une supervision simple et fiable, essentielle pour la qualité de service que nous devons à nos clients.
On-premise ou cloud, Bleemeo supervise les clusters Kubernetes de mes clients sans complexité. Un outil que je recommande pour sa simplicité et la clarté qu'il apporte.
Client depuis le premier jour, je suis ravi de Bleemeo. C'est facile à installer, efficace, et ça ne cesse de s'améliorer !
Pendant une courte pause déjeuner, nous avons installé Bleemeo, créé une métrique personnalisée, testé les alertes et étions prêts pour la production. La rapidité de déploiement est remarquable.
Le support Bleemeo est tout simplement légendaire — rapide, compétent et toujours présent quand on en a besoin.
Le déploiement de Bleemeo a été incroyablement rapide. En environ une heure, nous l'avons déployé sur plus de 100 serveurs et avons immédiatement obtenu une visibilité complète sur notre infrastructure.
Nous avons mis en place le monitoring de tous nos serveurs en quelques heures seulement. Le tableau de bord est clair, puissant et véritablement agréable à utiliser.
Nous avons déployé Bleemeo sur l'ensemble de notre infrastructure serveur en quelques heures seulement. Le monitoring de disponibilité nous alerte désormais instantanément dès qu'un service rencontre un problème.
Démo
Découvrez comment les équipes passent de l'installation au monitoring complet en moins de 5 minutes
Oui. Bleemeo surveille tout ce que Nagios peut — serveurs, services, réseau — plus les conteneurs et Kubernetes. Grâce à la découverte automatique, pas besoin d'écrire des plugins de vérification ou des définitions d'hôtes.
Non. L'agent Bleemeo (Glouton) détecte et surveille plus de 50 services automatiquement. Pas de NRPE, pas de scripts de plugins, pas d'objects.cfg.
Bleemeo inclut des seuils d'alerte préconfigurés pour chaque service découvert, plus une détection d'anomalies basée sur le ML. Notifications par email, Slack, PagerDuty ou webhooks — sans écriture manuelle de règles.
Oui. Installez l'agent Bleemeo à côté de Nagios, vérifiez la couverture, puis désactivez Nagios une fois convaincu. La plupart des équipes migrent en moins d'une semaine.
Oui. Contrairement à Nagios qui n'a aucun support natif des conteneurs, Bleemeo surveille Docker et Kubernetes nativement avec la découverte automatique des pods et services.
Oui. Collecte et recherche centralisée des logs incluse à 0,50€/Gio. Pas besoin d'une stack ELK séparée à côté de votre monitoring.
Oui. Surveillez jusqu'à 3 serveurs gratuitement, sans limite de durée — pas de séparation community vs. enterprise comme Nagios Core vs. Nagios XI. L'offre gratuite conserve 1 jour de métriques et n'inclut ni conteneurs, ni logs, ni SNMP, ni vSphere, qui viennent avec une offre payante.
Oui. Bleemeo surveille les équipements réseau et supporte le SNMP en plus du monitoring serveur et applicatif — le tout dans une seule plateforme.
Comparez également Bleemeo à :