Construido sobre Prometheus y OpenTelemetry
Sin dependencia del proveedor
Nagios fue pionero en monitoreo en los años 2000, pero su arquitectura basada en plugins y sus archivos de configuración manual no han seguido el ritmo de la infraestructura moderna. Bleemeo le ofrece descubrimiento automático, dashboards integrados y alertas con umbrales por defecto sensatos — sin plugins, sin NRPE, sin objects.cfg.
Prueba gratuita 15 díasSin tarjeta de créditoSin compromiso a largo plazo
Sin dependencia del proveedor
Almacenados en la UE (región de París) · Conforme al RGPD
En toda Europa y más allá
Más de 500 equipos abandonan despliegues Nagios heredados
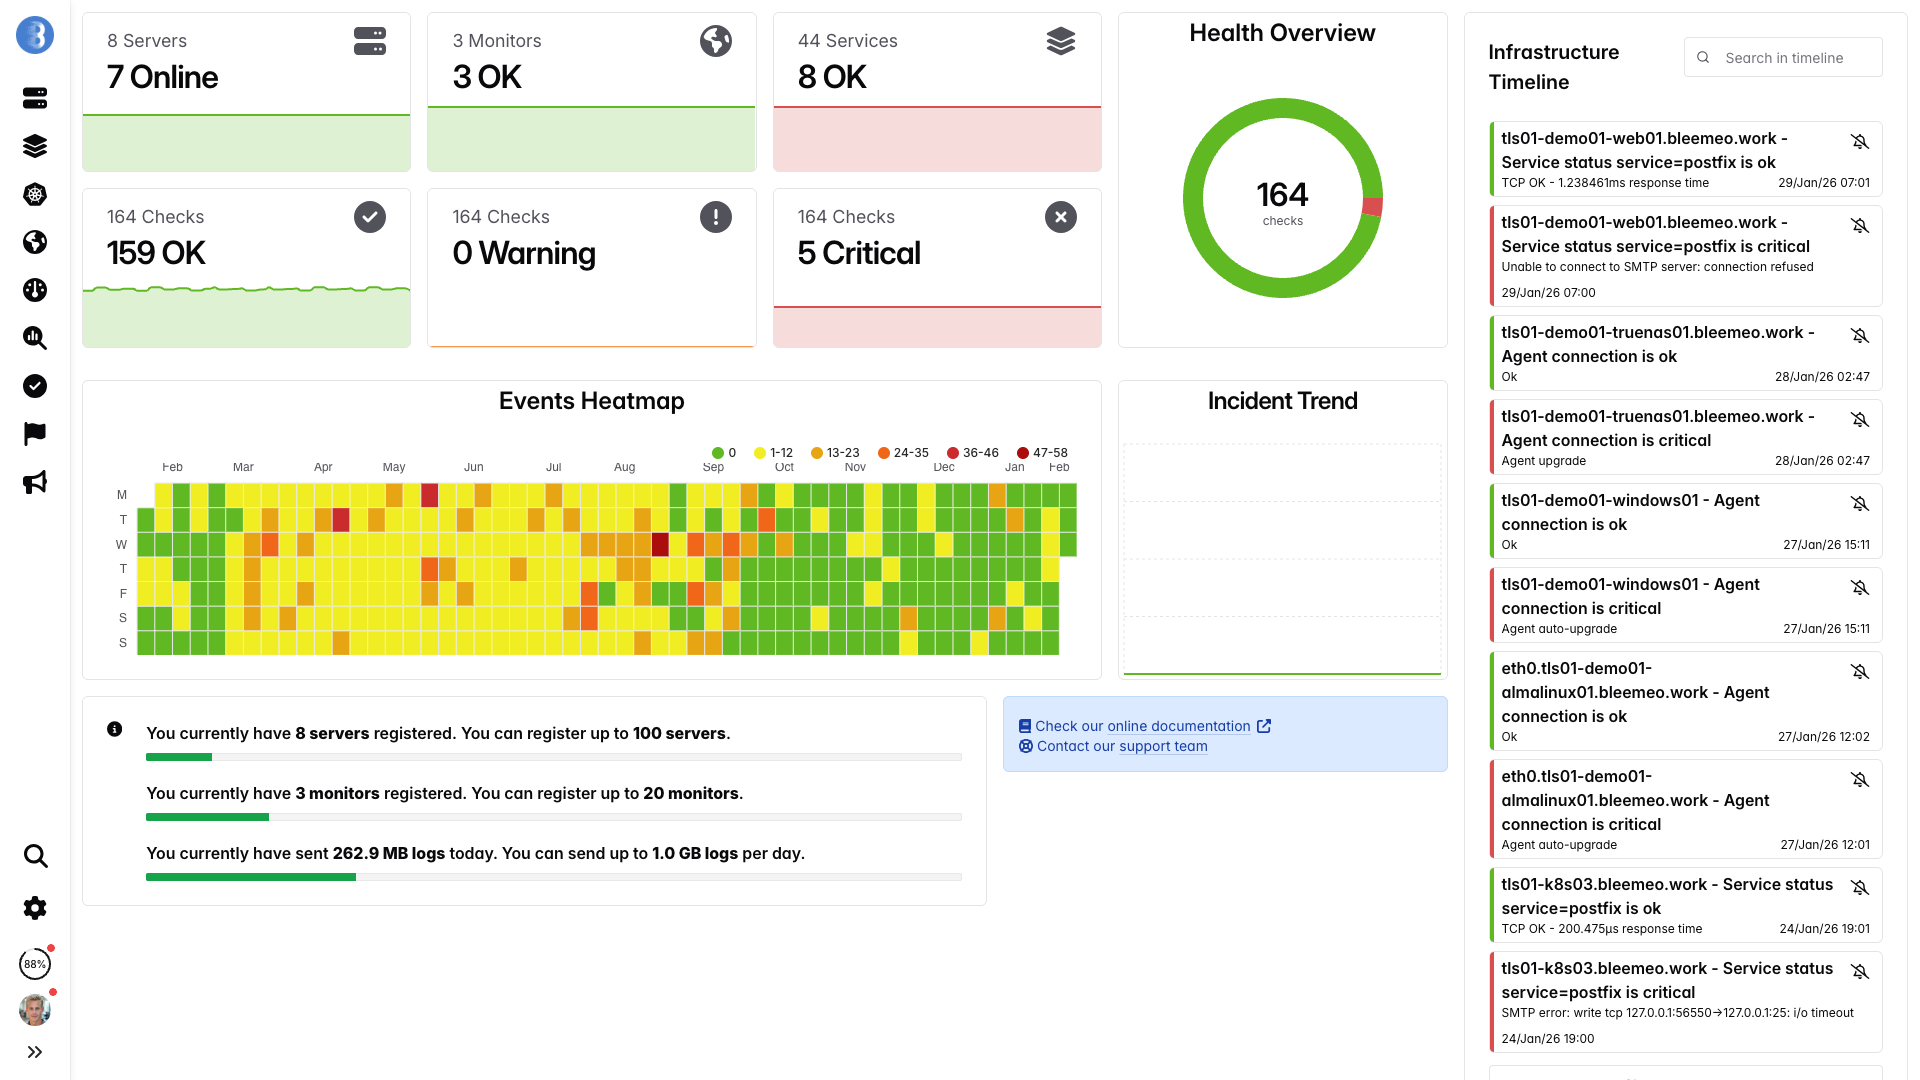
Dashboards en tiempo real, listos en minutos — sin configuración necesaria
Agente instalado en 30 segundos, primeros dashboards en 5 minutos — sin archivos .cfg ni rollout de NRPE
Un comando, sin configuración — métricas fluyendo en menos de un minuto.
Por qué cambiar
Configurar Nagios requiere editar archivos de texto complejos como hosts.cfg, services.cfg y commands.cfg, y luego recargar el demonio por cada cambio. Cada nuevo host o servicio debe definirse manualmente con comandos de verificación, intervalos, períodos de notificación, grupos de contacto y umbrales — a menudo decenas de líneas por objeto. Un solo error de sintaxis puede impedir que el demonio de Nagios reinicie, dejando su monitoreo ciego hasta que se encuentre y corrija el problema. Lo que lleva días o semanas con Nagios, toma solo minutos con el descubrimiento automático de Bleemeo, que detecta servicios, contenedores y componentes de infraestructura en cuanto se instala el agente.
Ejecutar Nagios significa que usted es responsable del propio servidor de monitoreo: parches del SO, actualizaciones de Apache o PHP, compatibilidad de plugins, espacio en disco para datos de rendimiento y actualizaciones del agente NRPE en cada servidor de su flota. Cada agente NRPE debe configurarse individualmente con comandos de verificación permitidos y reglas de firewall, creando una superficie de mantenimiento que crece linealmente con su infraestructura. La comunidad de Nagios se ha fragmentado en forks como Icinga 2, Naemon y Shinken, dificultando encontrar plugins actualizados, add-ons compatibles y documentación fiable. Bleemeo es una plataforma SaaS totalmente gestionada — sin servidores que parchear, sin agentes que configurar manualmente y sin repositorios de plugins que auditar — para que su equipo pueda enfocarse en resolver incidentes en lugar de cuidar el stack de monitoreo.
Nagios fue diseñado para centros de datos estáticos on-premise donde los hosts rara vez cambian y las direcciones IP son fijas. No tiene soporte nativo para contenedores, pods de Kubernetes, grupos de autoescalado ni funciones serverless. Cada vez que una instancia cloud escala hacia arriba o abajo, la definición del host correspondiente debe agregarse o eliminarse manualmente — o mediante scripts externos frágiles — generando alertas obsoletas, desviación de configuración y notificaciones fantasma de hosts que ya no existen. Bleemeo fue construido desde el primer día para entornos efímeros y cloud-native donde la infraestructura cambia constantemente.
La interfaz web predeterminada de Nagios — conocida como interfaz CGI — apenas ha cambiado en más de una década. Solo ofrece tablas básicas de estado de hosts y servicios, sin dashboards en tiempo real, gráficos interactivos de series temporales ni diseño responsive para móviles. La mayoría de equipos terminan instalando frontends de terceros como Thruk, Adagios, o añadiendo Grafana con PNP4Nagios solo para obtener visualizaciones utilizables, agregando aún más componentes que mantener y asegurar. Bleemeo proporciona dashboards modernos y personalizables con streaming de métricas en tiempo real y apps nativas para iOS y Android listas para usar, sin necesidad de combinar múltiples herramientas para obtener visibilidad básica.
Configuramos el monitoreo de todos nuestros servidores en solo unas pocas horas. El dashboard es claro, potente y realmente agradable de usar.
Comparativa
| Feature | Nagios | Bleemeo |
|---|---|---|
| Tiempo de configuración | Días a semanas de definiciones manuales de hosts y servicios | Minutos con un solo comando de instalación del agente |
| Configuración | Edición manual de objects.cfg, commands.cfg y contacts.cfg | Descubrimiento automático de servicios, contenedores e infraestructura |
| Cloud-Native | Sin soporte para contenedores ni Kubernetes; solo modelo de hosts estático | Integración nativa con Kubernetes, Docker y proveedores cloud |
| Apps móviles | Sin aplicación móvil oficial disponible | Apps nativas iOS y Android con notificaciones push |
| Alertas | Notificaciones básicas por email y pager mediante scripts personalizados | Enrutamiento inteligente con SMS, Slack, Teams, PagerDuty y webhooks |
| Mantenimiento | Servidor auto-alojado que requiere parches del SO, actualizaciones de plugins y gestión de NRPE | Plataforma SaaS totalmente gestionada con cero mantenimiento de servidor |
| Dashboards | UI integrada anticuada; requiere Thruk o Grafana para dashboards utilizables | Dashboards modernos y personalizables |
| Gestión de logs | No incluida; requiere desplegar un stack ELK o Graylog aparte | Recopilación, búsqueda y análisis de logs integrados en la misma plataforma |
| Detección de anomalías | Solo umbrales estáticos; sin machine learning ni análisis de tendencias | Detección de anomalías impulsada por ML con aprendizaje automático de líneas base |
| Prometheus y OpenTelemetry | Sin soporte nativo; arquitectura basada en checks incompatible | Scraping nativo de exporters Prometheus y soporte de colector OpenTelemetry |
| Escalabilidad | Arquitectura de servidor único; configuraciones distribuidas requieren add-ons complejos como Mod Gearman o DNX | SaaS cloud-native que escala automáticamente de 10 a más de 10.000 agentes |
| API | Interfaz de comandos externos limitada vía command pipe; sin API REST en Core | API REST completa para automatización, integración y flujos de trabajo personalizados |
| Monitoreo de disponibilidad | Plugin check_http básico; sin sondeo multi-ubicación ni reportes SLA | Verificaciones de disponibilidad globales desde múltiples ubicaciones con dashboards SLA |
| Precios | Core es gratuito; Nagios XI Standard cuesta $2.595 de lista por 100 nodos más $2.104 al año de mantenimiento, además de infraestructura y tiempo de sysadmin | 10,99 EUR/mes por servidor, con 1.000 métricas, 20 contenedores y un check de disponibilidad incluidos (al menos 5 por cuenta); logs a 0,50 EUR/GiB |
Lo básico que una herramienta de monitoreo debe hacer bien, en un solo lugar y sin nada que instalar de nuestro lado.
Costos
Nagios Core puede ser open source, pero un stack de nivel producción cuesta una licencia, un servidor y el tiempo de ingeniería para mantenerlo en marcha. Aquí tiene la comparación para 50 servidores durante 3 años, con Nagios XI a su precio de lista publicado.
Escenario: 50 servidores durante 3 años, despliegue en la nube. Tiempo de ingeniería a 450 € al día, el mismo modelo que nuestra calculadora de costes, donde puede introducir sus propias cifras. Precios de lista comprobados el 4 de octubre de 2026; dólares convertidos a 0,91.
El desglose anterior supone 50 servidores durante 3 años. La calculadora le permite usar sus propias cifras, número de servidores y add-ons incluidos, para estimar su ahorro al reemplazar Nagios con Bleemeo.
Ventajas
Instale nuestro agente ligero y descubre automáticamente servicios como MySQL, PostgreSQL, Redis, Nginx, Apache, contenedores Docker y pods Kubernetes. No hay archivos de configuración que escribir, ni comandos de verificación que definir, ni recargas de demonio que ejecutar. Los nuevos servicios se detectan y monitorean en segundos tras aparecer en el host, eliminando las definiciones manuales de objetos que consumen tanto tiempo con Nagios.
Construida desde cero para infraestructura moderna y dinámica. Bleemeo soporta nativamente clusters Kubernetes, runtimes Docker y containerd, instancias AWS, Azure y GCP. Las cargas de trabajo efímeras que escalan arriba y abajo se rastrean automáticamente — sin definiciones de hosts obsoletas, sin alertas fantasma y sin scripts de limpieza manual requeridos.
Cada servicio descubierto llega con umbrales por defecto sensatos, así que las alertas funcionan desde el primer día sin escribir un solo check. El escalado, los turnos de guardia y el enrutamiento flexible de notificaciones envían alertas al equipo correcto vía Slack, Microsoft Teams, PagerDuty, SMS o webhooks, mientras la detección de anomalías por ML aporta contexto sin despertar nunca a nadie — previniendo la fatiga de alertas que afecta a los despliegues de Nagios.
Dashboards modernos y responsive con streaming de métricas en tiempo real proporcionan visibilidad instantánea de toda su infraestructura. Cree vistas personalizadas en minutos con widgets drag-and-drop, gráficos interactivos de series temporales y mapas de topología. A diferencia de Nagios, no necesita instalar Thruk, Grafana ni PNP4Nagios para obtener visualizaciones utilizables.
Las aplicaciones nativas para iOS y Android le permiten monitorear toda su infraestructura y responder a incidentes desde cualquier lugar. Reciba notificaciones push en cuanto se detecte un problema, confirme alertas, vea dashboards y profundice en detalles de métricas — todo desde su teléfono o tablet, sin necesidad de VPN para alcanzar un servidor Nagios on-premise.
Métricas, logs, monitoreo de disponibilidad y detección de anomalías unificados en una sola plataforma. Con Nagios, los equipos típicamente combinan herramientas separadas para gestión de logs (ELK o Graylog), dashboards (Grafana) y verificaciones de disponibilidad (servicios externos), creando un stack fragmentado costoso de ejecutar y difícil de correlacionar. Bleemeo reúne todo para que pueda ir de la alerta a la causa raíz en una sola interfaz.
Migración
Cree su cuenta gratuita de Bleemeo e instale el agente ligero en cada servidor con un solo comando. El agente soporta Debian, Ubuntu, RHEL, CentOS, Alpine y la mayoría de distribuciones Linux principales. La instalación toma menos de un minuto por host:
wget -qO- 'https://get.bleemeo.com?accountId=...'En segundos tras la instalación, el agente descubre automáticamente servicios en ejecución como MySQL, PostgreSQL, Redis, Nginx, Apache, Elasticsearch, contenedores Docker y pods Kubernetes. Inicie sesión en el dashboard de Bleemeo para verificar que todos sus servicios críticos están detectados y las métricas fluyen. Para aplicaciones personalizadas, puede agregar endpoints compatibles con Prometheus o verificaciones personalizadas en minutos.
Configure canales de notificación — Slack, Microsoft Teams, PagerDuty, SMS, email o webhooks — a través de la interfaz web intuitiva. Bleemeo viene con umbrales predeterminados sensatos para todos los servicios descubiertos, por lo que obtiene alertas significativas de inmediato. Personalice umbrales y reglas de enrutamiento para que coincidan con la estructura de guardia y las políticas de escalado de su equipo sin editar un solo archivo de configuración.
Cree dashboards personalizados para replicar y mejorar las vistas que tenía en Nagios, Thruk o Grafana. El constructor de dashboards de Bleemeo le permite arrastrar y soltar widgets para CPU, memoria, disco, red y métricas específicas de aplicaciones. Comparta dashboards con su equipo o muéstrelos en pantallas montadas en la pared para conciencia operativa en tiempo real.
Mantenga Nagios ejecutándose junto a Bleemeo durante una o dos semanas para validar la cobertura, precisión de alertas y flujos de trabajo del equipo. Compare las alertas generadas por ambos sistemas para ganar confianza en que Bleemeo captura todo lo que Nagios detecta — y más, gracias al descubrimiento automático y la detección de anomalías. Este período en paralelo también da tiempo a su equipo para familiarizarse con la nueva interfaz y las apps móviles.
Una vez que su equipo esté seguro con la cobertura y las alertas de Bleemeo, conviértalo en su plataforma de monitoreo principal y desactive Nagios. Elimine el servidor Nagios, desinstale los agentes NRPE de sus hosts y retire la infraestructura asociada. Liberará inmediatamente tiempo de sysadmin que antes se dedicaba al mantenimiento de plugins, gestión de archivos de configuración y mantenimiento del servidor Nagios.
Ingenieros y CTOs confían en Bleemeo para monitorear su infraestructura
Necesitamos que nuestros equipos se centren en nuestro negocio principal —la cartelería digital— en lugar de en la supervisión de la infraestructura. Bleemeo supervisa todo nuestro entorno, desde el servidor dedicado hasta Azure, y libera a nuestros equipos de alertas inútiles garantizando al mismo tiempo nuestra calidad de servicio.
Bleemeo nos acompaña desde hace años: una supervisión simple y fiable, esencial para la calidad de servicio que debemos a nuestros clientes.
On-premise o en la nube, Bleemeo supervisa los clústeres Kubernetes de mis clientes sin complejidad. Una herramienta que recomiendo por su simplicidad y la claridad que aporta.
Cliente desde el primer día, estoy encantado con Bleemeo. Es fácil de instalar, eficiente y no para de mejorar.
Durante una breve pausa para almorzar, instalamos Bleemeo, creamos una métrica personalizada, probamos las alertas y estábamos listos para producción. La velocidad de despliegue es notable.
El soporte de Bleemeo es simplemente legendario: rápido, competente y siempre disponible cuando lo necesitamos.
Bleemeo fue increíblemente rápido de desplegar. En aproximadamente una hora lo implementamos en más de 100 servidores y obtuvimos visibilidad completa de nuestra infraestructura de inmediato.
Configuramos el monitoreo de todos nuestros servidores en solo unas pocas horas. El dashboard es claro, potente y realmente agradable de usar.
Desplegamos Bleemeo en toda nuestra infraestructura de servidores en solo unas pocas horas. El monitoreo de disponibilidad ahora nos alerta instantáneamente cuando un servicio tiene un problema.
En acción
Descubra cómo los equipos pasan de la instalación al monitoreo completo en menos de 5 minutos
Sí. Bleemeo monitorea todo lo que Nagios puede — servidores, servicios, red — además de contenedores y Kubernetes. Con el descubrimiento automático, no necesita escribir plugins de verificación ni definiciones de hosts.
No. El agente de Bleemeo (Glouton) detecta y monitorea más de 50 servicios automáticamente. Sin NRPE, sin scripts de plugins, sin objects.cfg.
Bleemeo incluye umbrales de alerta preconfigurados para cada servicio descubierto, además de detección de anomalías basada en ML. Notificaciones por email, Slack, PagerDuty o webhooks — sin necesidad de escribir reglas manualmente.
Sí. Instale el agente Bleemeo junto a Nagios, verifique la cobertura y luego desactive Nagios cuando esté seguro. La mayoría de equipos migran en menos de una semana.
Sí. A diferencia de Nagios, que no tiene soporte nativo para contenedores, Bleemeo monitorea Docker y Kubernetes de forma nativa con descubrimiento automático de pods y servicios.
Sí. Recopilación y búsqueda centralizada de logs incluida a 0,50€/GiB. Sin necesidad de un stack ELK separado junto a su monitoreo.
Sí. Monitoree hasta 3 servidores gratis, para siempre — sin división comunidad vs. empresa como Nagios Core vs. Nagios XI. El plan gratuito conserva 1 día de métricas y no incluye contenedores, logs, SNMP ni vSphere, que llegan con un plan de pago.
Sí. Bleemeo monitorea dispositivos de red y soporta SNMP junto con el monitoreo de servidores y aplicaciones — todo en una plataforma.
Compare también Bleemeo con: