Servicios fiables sin un equipo dedicado al monitoreo.Monitoreo de infraestructura que simplemente funciona.
Bleemeo da a tu equipo visibilidad completa sobre servidores, contenedores y clústeres de Kubernetes — dashboards, alertas y logs listos desde la primera instalación. Detectas los incidentes antes que tus clientes, tus ingenieros siguen centrados en el producto y el precio por servidor mantiene la factura predecible. Empresa europea, datos almacenados en la UE.
Sin tarjeta de crédito · 15 días de prueba gratuita · Listo en producción en 5 minutos
Un monitoreo que se anticipa
Una fecha, no una gráfica en rojo
Bleemeo prevé cuándo se llenarán el disco, la memoria y el swap a partir de su propio historial, y pone la fecha en su informe semanal.
Anomalías señaladas, sin despertar a nadie
Un modelo Chronos-Bolt aprende dos semanas de cada métrica y marca lo que sale de su rango habitual. Contexto para la guardia, no una alarma a las 3 de la mañana.
Pregunte a su asistente de IA
Nuestro servidor MCP da a Claude, ChatGPT, Mistral Le Chat o Cursor más de 30 herramientas de solo lectura: consultas PromQL, métricas, eventos y logs.
Estándares abiertos, sin dependencia
PromQL, Prometheus remote write y OpenTelemetry de entrada; un agente Go de código abierto (Glouton) en sus servidores.
Una sola plataforma
Cada servidor, contenedor y servicio — un solo lugar para vigilarlos
Instala un agente en Linux, Windows o Kubernetes y cada servicio de la máquina se detecta automáticamente — MySQL, PostgreSQL, Redis, Nginx y muchos más. Los servicios de AWS y Azure llegan a través de sus API, los equipos de red por SNMP y los logs entran en la misma herramienta. Una sola vista de tus servidores, contenedores, bases de datos y nubes, sin ensamblar cuatro productos.
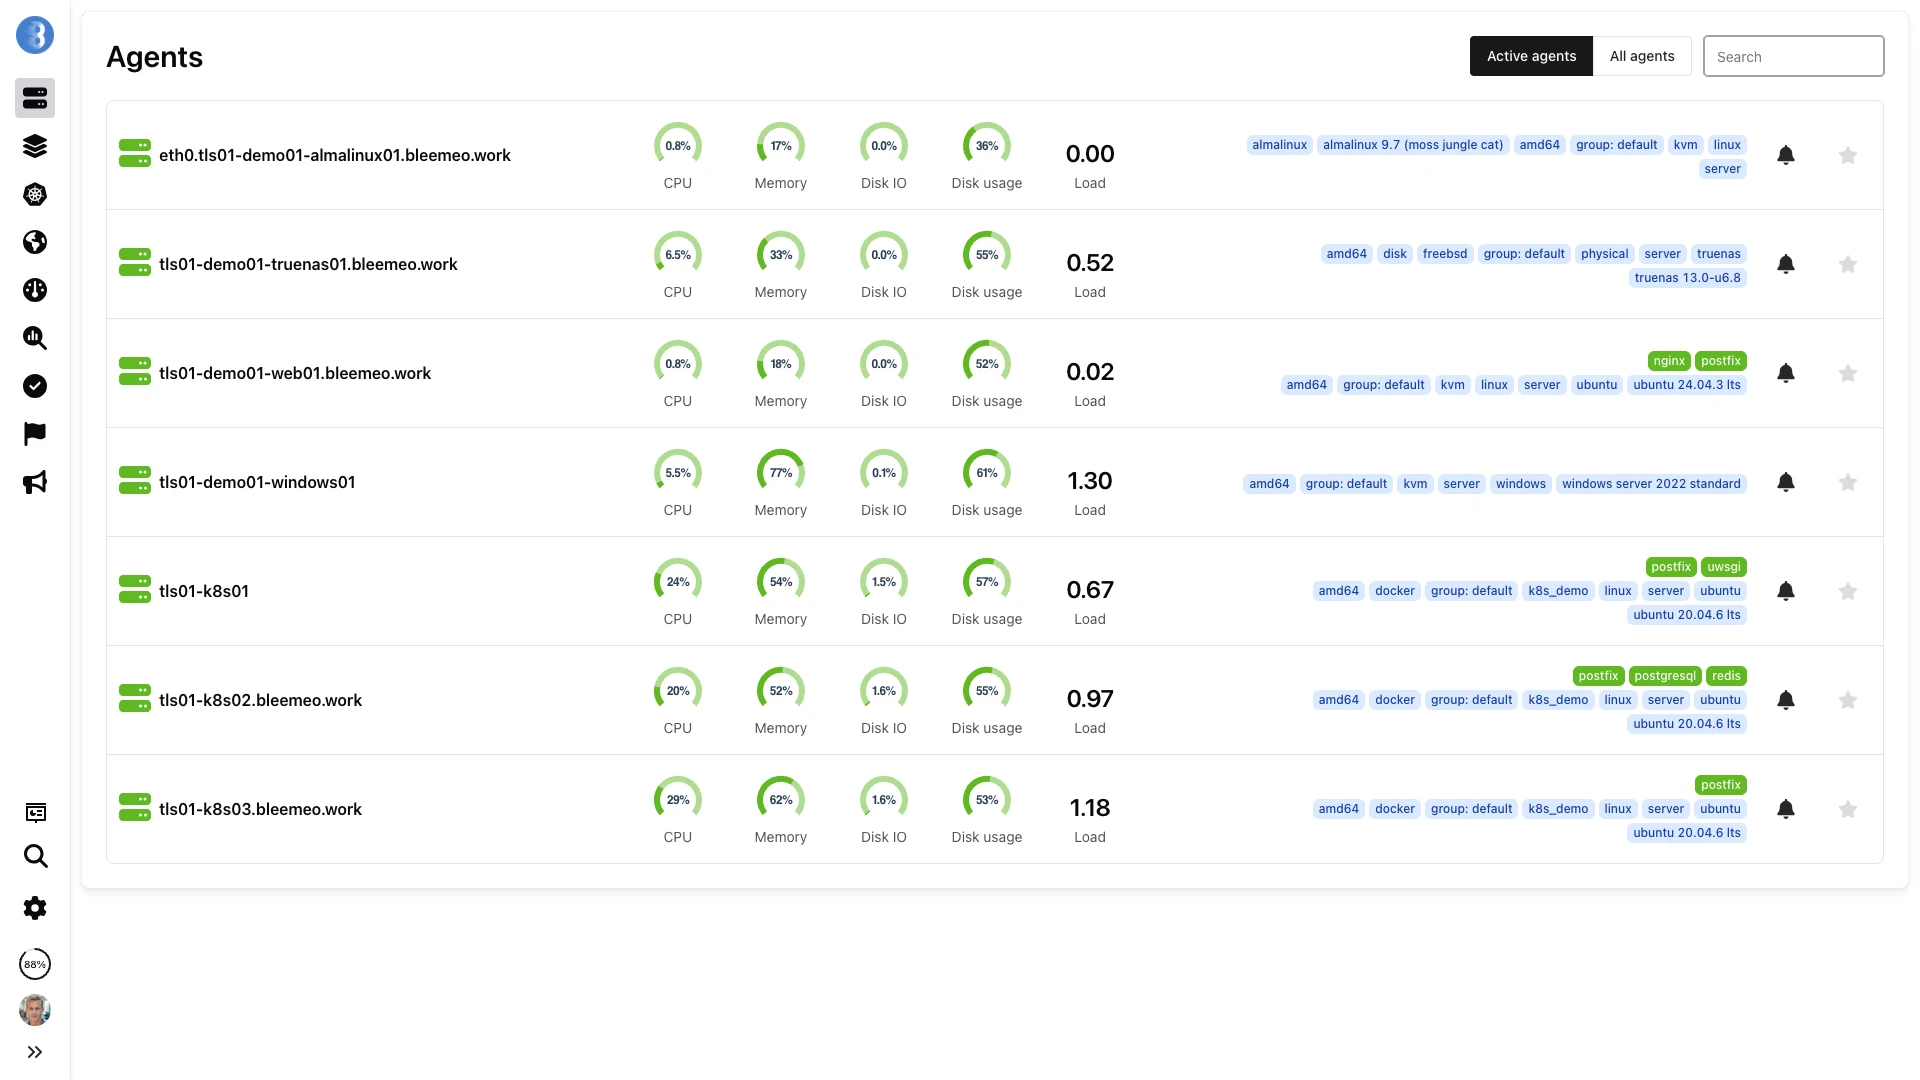
Equipos que entregan producto en lugar de vigilar dashboards
Desde startups SaaS hasta medianas empresas, 500+ compañías confían en Bleemeo para mantener su producción en marcha

Lo que dicen nuestros clientes
Ingenieros y CTOs confían en Bleemeo para monitorear su infraestructura
Necesitamos que nuestros equipos se centren en nuestro negocio principal —la cartelería digital— en lugar de en la supervisión de la infraestructura. Bleemeo supervisa todo nuestro entorno, desde el servidor dedicado hasta Azure, y libera a nuestros equipos de alertas inútiles garantizando al mismo tiempo nuestra calidad de servicio.
Bleemeo fue increíblemente rápido de desplegar. En aproximadamente una hora lo implementamos en más de 100 servidores y obtuvimos visibilidad completa de nuestra infraestructura de inmediato.
Desplegamos Bleemeo en toda nuestra infraestructura de servidores en solo unas pocas horas. El monitoreo de disponibilidad ahora nos alerta instantáneamente cuando un servicio tiene un problema.
Comparativa
Construirlo, pagarlo de más o simplemente usarlo
Construir tu propio stack, comprar una plataforma enterprise o tomar el camino intermedio: esto es lo que cuesta realmente cada opción, tiempo de ingeniería incluido.
Open Source DIY
Prometheus + Grafana + Alertmanager + Thanos + ... o Zabbix, Nagios, Centreon, Checkmk- Semanas de configuración y ajuste inicial
- Mantenimiento y actualizaciones continuas
- Planificación de almacenamiento y gestión de capacidad
- La alta disponibilidad es tu problema
- Control total sobre todo
- Sin coste de licencia recurrente
Adecuado si ya tienes un equipo de plataforma experto en monitoreo y tiempo para dedicarle.
- Rico en funcionalidades y potente
- Infraestructura gestionada
- Precios complejos: líneas separadas para hosts, logs, APM y métricas personalizadas
- Facturas que crecen más rápido que tu infraestructura
- Curva de aprendizaje pronunciada
- A menudo más herramienta de la necesaria
Diseñado para grandes empresas con grandes presupuestos y grandes equipos.
Bleemeo
Monitoring llave en mano para equipos en crecimiento- Listo en producción en 5 minutos
- Precios simples por host, sin costes ocultos
- Descubrimiento automático de 100+ tecnologías
- 13 meses de retención incluidos
- Compatible con Prometheus y OpenTelemetry
- Empresa europea, residencia de datos en la UE
Toda la visibilidad que necesitas, sin la complejidad innecesaria.
Lo que cuesta realmente el autoalojamiento
¿Quién monitorea el monitoreo?
Si su servidor de monitoreo cae junto con el resto, nadie recibe la alerta. Bleemeo funciona fuera de su infraestructura.
Actualizaciones y parches de seguridad
Prometheus, Grafana, Alertmanager y Thanos son cuatro ciclos de versiones que seguir. En Bleemeo, ninguno.
Alta disponibilidad
Dos instancias como mínimo para no perder alertas durante un mantenimiento.
Retención
Prometheus guarda 15 días por defecto; para más, hacen falta Thanos o Mimir y almacenamiento de objetos. Bleemeo guarda 13 meses en Professional.
Para 50 servidores durante 3 años, nuestra calculadora cuenta 17 días de ingeniero al año de mantenimiento a 450 € al día, 14 días de instalación y un par en alta disponibilidad: 39.397 € autogestionado, frente a 19.782 € con Bleemeo Professional.
Haga su cálculo →Fundamentos
Lo que tu equipo recupera
Operamos todo el stack de monitoreo — recopilación, almacenamiento, dashboards, alertas y retención a largo plazo — y el tiempo que tu equipo dedicaría a Prometheus, Grafana, Alertmanager y Thanos vuelve a tu producto.
Visibilidad desde el primer minuto
Instala un agente y todo se descubre automáticamente. Sin exporters que configurar, sin scrape targets que gestionar, sin dashboards que construir desde cero. Glouton detecta los servicios mediante sondas TCP y se adapta cuando tu stack cambia — sin reinicio.
Una factura que puedes anticipar
Precio simple por host, sin facturas sorpresa. En Professional, cada servidor incluye 1.000 métricas y 20 contenedores; los logs son de pago por uso, por GiB, y los usuarios, paneles y alertas nunca se facturan. Siempre sabes lo que vas a pagar.
Alertas ya ajustadas para ti
Dashboards preconstruidos, reglas de alerta por defecto y 13 meses de retención incluidos. Visibilidad real en minutos, no semanas de configuración.
Nada que alojar, parchear ni actualizar
Olvídate de la capacidad de almacenamiento, la federación, la alta disponibilidad y las actualizaciones. Nosotros gestionamos la plataforma — tú solo la usas. Sin bases de datos time series que ajustar, sin políticas de retención que configurar, sin estrategia de backup que planificar para tus datos de monitoreo.
Todo lo que se espera de un monitoreo, incluido
Lo básico que una herramienta de monitoreo debe hacer bien, en un solo lugar y sin nada que instalar de nuestro lado.
Recopilar
- Servidores Linux y Windows
- Docker y Kubernetes
- Dispositivos de red SNMP
- VMware vSphere, AWS y Azure
- 100+ integraciones, exporters de Prometheus, OTLP
- Checks personalizados, incluidos los plugins de Nagios
Visualizar
- Dashboards en tiempo real y plantillas
- 13 meses de retención (Professional)
- Búsqueda en los logs
- Checks de uptime desde 7 ubicaciones, caducidad de SSL y dominio
- Páginas de estado públicas
Alertar
- Umbrales por defecto listos para usar
- Reglas de alerta PromQL
- Slack, Teams, PagerDuty, Opsgenie, ilert, email, SMS, webhooks
- Guardias y escalado
- Silencios para las ventanas de mantenimiento
- Apps para iOS y Android
Administrar
- Usuarios, roles y 2FA
- Registro de auditoría
- API REST
- Servidor MCP
- Informe semanal
Monitoreo de servidores
Monitoreo de servidores que se configura solo
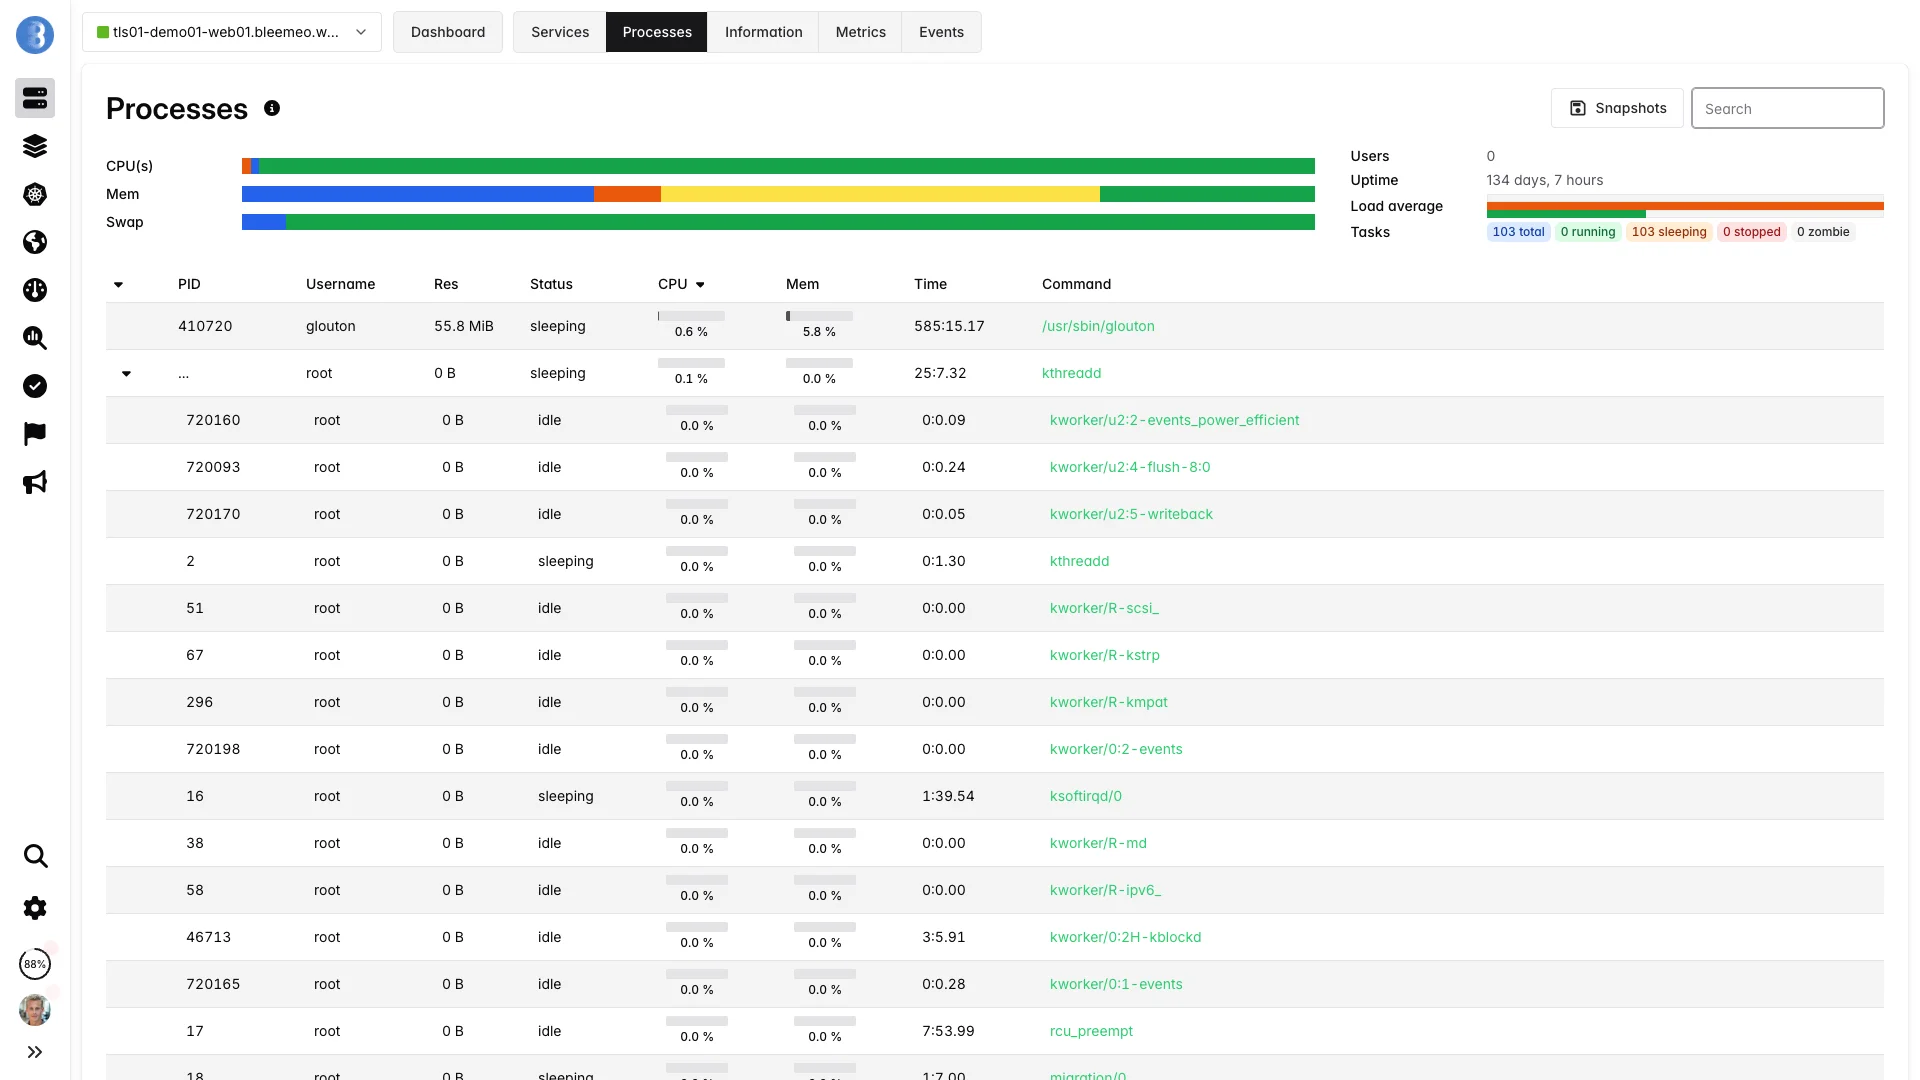
La mayoría de herramientas de monitoring te obligan a definir qué monitorear, escribir archivos de configuración y construir dashboards antes de ver una sola métrica. Con Bleemeo, instalas un agente ligero y él hace el resto.
Glouton, nuestro agente open source, descubre automáticamente cada servicio en ejecución — bases de datos, servidores web, colas, contenedores — y empieza a recopilar métricas con resolución de 10 segundos. Los dashboards y alertas están listos antes de que termines tu café.
Cobertura
De 5 a 500 servidores, una sola herramienta
Monitoreo integral para cada parte de su infraestructura
Monitoreo de servidores
Servidores fisicos y virtuales, VMs e infraestructura bare-metal. Monitoree métricas del sistema, procesos y servicios.
Explorar el monitoreo de servidores →Monitoreo de Kubernetes
Observabilidad completa de Kubernetes. Monitoree clusters, nodos, pods y servicios con descubrimiento automático.
Explorar el monitoreo Kubernetes →Monitoreo de aplicaciones
Monitoree bases de datos, servidores web, colas de mensajes y aplicaciones personalizadas. Rastree rendimiento y disponibilidad.
Descubrir el monitoreo de aplicaciones →Monitoreo de contenedores
Métricas de Docker y contenedores. Monitoree uso de recursos, estado y rendimiento en toda su flota de contenedores.
Descubrir el monitoreo de contenedores Docker →Monitoreo de red
Rastree rendimiento de red, uso de ancho de banda y conectividad. Monitoree switches, routers y balanceadores de carga.
Explorar el monitoreo de red →Monitoreo en la nube
AWS, Azure, GCP y entornos multi-nube. Visibilidad unificada en toda su infraestructura en la nube.
Descubrir el monitoreo AWS →Gestión de logs
Logs junto a tus métricas, facturados por GiB
Con la mayoría de proveedores de monitoring, los logs son un producto separado que requiere infraestructura dedicada. Con Bleemeo, la recopilación de logs está integrada en el mismo agente que ya utilizas — sin stack ELK que desplegar, sin Loki que configurar. Solo pagas por lo que ingieres a 0,50€/GiB, sin tarifas ocultas de indexación ni recargos de retención.
Prometheus
¿Te encanta Prometheus? Ahórrate el trabajo de ops.
Prometheus es potente — y ejecutarlo en producción implica ocuparse del almacenamiento, la retención, la federación, la alta disponibilidad y una constelación de exporters.
Bleemeo te ofrece compatibilidad total con PromQL respaldada por almacenamiento gestionado a largo plazo con 13 meses de retención. Conserva el lenguaje de consultas que ya conoces, deja atrás la carga de infraestructura.
scrape_configs:
  - job_name: 'nodes'
    static_configs:
      - targets:
        - 'node1:9100'
        - 'node2:9100'

  - job_name: 'kubernetes'
    kubernetes_sd_configs:
- role: podOpenTelemetry
Trae tu instrumentación. Vete cuando quieras.
¿Ya usas OpenTelemetry o exporters de Prometheus? Bleemeo acepta tus métricas y logs tal cual. Sin agentes propietarios, sin SDKs específicos del proveedor. Tu instrumentación sigue siendo portable — nosotros solo le damos un hogar.
IA & ML
Avisos más tempranos, menos interrupciones
Los equipos pequeños no pueden permitirse perseguir falsas alarmas. Bleemeo aprende el ritmo diario y semanal de CPU, memoria y swap de cada servidor y señala las horas que salen del rango esperado — sin ningún umbral que configurar y sin despertar a nadie. Un segundo modelo responde a la otra pregunta: no «¿es esto normal ahora?», sino «¿cuándo se agota?»
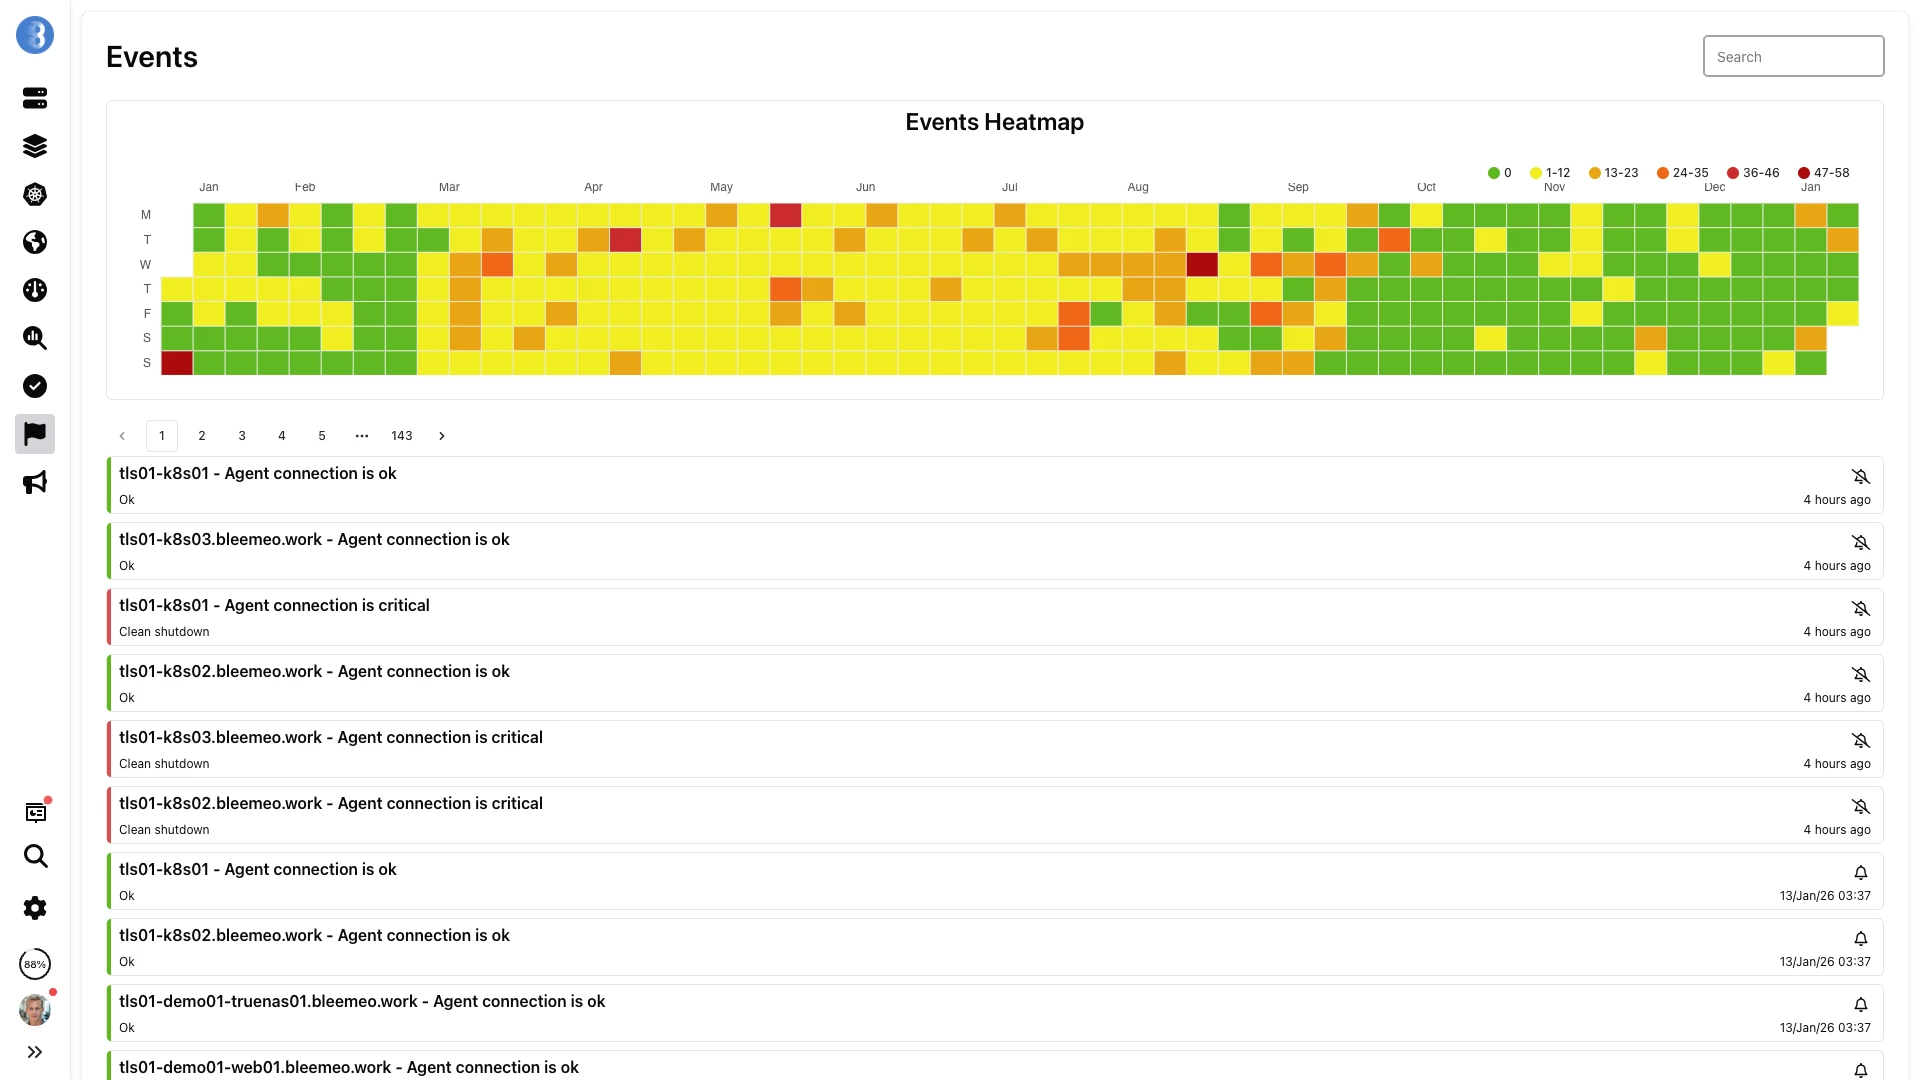
Un año de eventos de un vistazo — el mismo historial que leen los modelos para aprender cómo es una semana normal.
Detección de anomalías
Bleemeo aprende el ritmo diario y semanal de CPU, memoria y swap de cada servidor a partir de las dos últimas semanas y señala las horas que salen del rango esperado. Nada que configurar, y nunca te despierta: una anomalía es una señal, no una severidad.
Previsión de capacidad
Las tendencias de disco, memoria y swap se proyectan a una fecha, no a un porcentaje: «este volumen alcanza el 90 % el 3 de abril». Solo se anuncia una fecha si la deriva se confirmó en dos ventanas — un servicio que arranca y toma la mitad de la RAM no es una fuga.
Antelación medida
Cada anomalía se empareja con la primera alerta que la siguió en el mismo host: la interfaz muestra la diferencia real — «alerta 42 minutos después» — y la antelación mediana por vista. Ves lo que vale la detección en tu propia infraestructura.
Aprende de tus respuestas
Cada anomalía espera un sí o un no. Las falsas alarmas repetidas pausan por sí solas la detección en esa métrica: una señal ruidosa se calla, en lugar de enseñar a tu equipo a ignorar la función.
Sugerencias de reducción de ruido Beta
Bleemeo agrupa tus alertas recurrentes y propone el silencio o la configuración flappy que las callaría, precargado y a un clic. Busca en tu historial de eventos por significado en lugar de por palabras exactas, y pregunta si ya se vio algo parecido.
Servidor MCP para asistentes de IA
Conecta Claude, Cursor o VS Code a través de nuestro servidor Model Context Protocol. Más de 30 herramientas de solo lectura permiten a un asistente responder sobre la salud de tu infraestructura — puede leerlo todo y no modificar nada.
Seguridad
Tus datos de monitoreo son el mapa de tu infraestructura. Los protegemos en consecuencia.
La seguridad no es un complemento ni una función reservada al plan enterprise — está integrada en cada capa de la plataforma, desde el agente que se ejecuta en tus servidores hasta el almacenamiento donde se conservan tus métricas y logs.
Cada agente se autentica con la nube de Bleemeo usando credenciales únicas vinculadas a tu cuenta. No hay flujos de datos anónimos ni endpoints compartidos — cada fuente de métricas se verifica antes de que se acepte un solo punto de datos. Siempre sabes exactamente qué está reportando en tu cuenta, y nada no autorizado puede inyectar datos falsos en tus dashboards.
- Cifrado TLS 1.3 para todos los datos en tránsito
- Cifrado AES-256 para todos los datos en reposo
- Autenticación por agente con credenciales únicas
- Control de acceso basado en roles y registro de auditoría
Europeo
Una empresa europea, no solo una región europea
Cualquier proveedor puede alquilar un rack en Fráncfort. Menos pueden decirte con qué empresa contratas, bajo qué derecho y qué sale exactamente de tus servidores.
Contratas con una empresa francesa
Bleemeo es una empresa francesa, fundada en Toulouse en 2015 y dirigida desde allí. Se te factura en euros, bajo derecho francés, con un delegado de protección de datos al que puedes llegar de verdad y un soporte en tu propia zona horaria — no una entidad estadounidense con una filial europea adosada.
Tus métricas se quedan en la región de París
Las métricas y los logs se almacenan en la Unión Europea, en la región de París. Una región, una jurisdicción, con nombre — en lugar de los «centros de datos europeos» que escribe todo el mundo. La lista completa de encargados, incluidos los pocos fuera de la UE amparados por cláusulas contractuales tipo, está en la página de seguridad.
Ninguna caja negra en tus servidores
Glouton, el agente que instalas, es de código abierto bajo licencia Apache 2.0. Lo que recopila y lo que envía se puede leer línea a línea. Para quien tiene que justificar un proveedor, es una garantía más sólida que una insignia de residencia.
Página de estado pública
Muestra a tus clientes la disponibilidad que ofreces
Los mismos checks que alertan a tu equipo alimentan una página de estado pública en tu propio dominio: salud de los servicios en tiempo real, incidentes en curso e historial de disponibilidad. Una URL que tu soporte puede compartir durante un incidente — sin otra herramienta de status page que comprar ni nada que actualizar a mano.
Descubrir el monitoreo de disponibilidad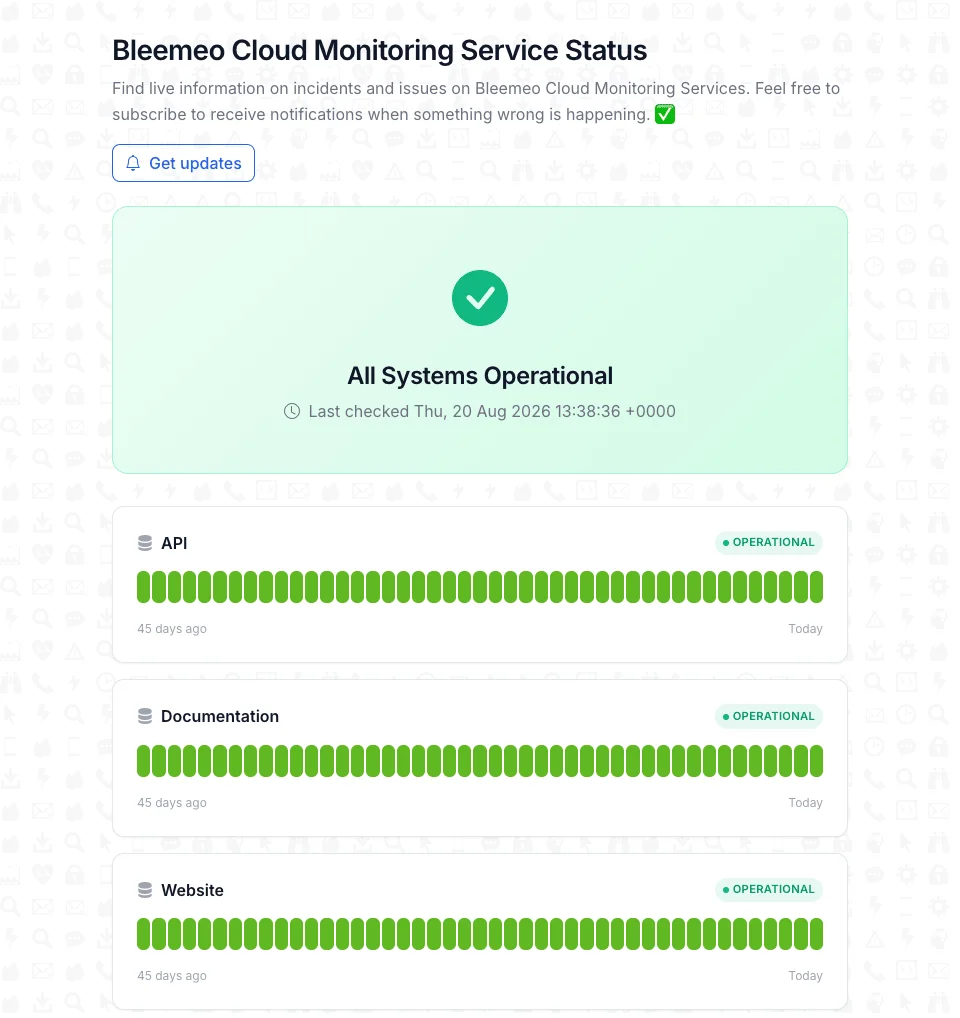
Es la propia página de estado de Bleemeo — consúltala en directo.
Preguntas frecuentes
Todo lo que necesita saber sobre la plataforma de monitoreo de Bleemeo
¿Cómo funciona su plataforma de monitoreo?
Bleemeo utiliza un agente ligero de código abierto llamado Glouton que se instala en sus servidores, VMs o clusteres de Kubernetes. El agente descubre automáticamente los servicios y aplicaciones en ejecución, recopila métricas del sistema cada 10 segundos y transmite los datos de forma segura a nuestra plataforma en la nube. Desde allí, obtiene paneles en tiempo real, alertas inteligentes y 13 meses de retención de métricas. Para servicios en la nube, nos integramos directamente con AWS CloudWatch y Azure Monitor. La plataforma también acepta datos a través del protocolo OpenTelemetry (OTLP).
¿Qué tipos de infraestructura y aplicaciones soportan?
Bleemeo soporta más de 100 tecnologías listas para usar con descubrimiento automático. Esto incluye: Sistemas operativos (Linux, Windows), Contenedores (Docker, containerd, Kubernetes), Bases de datos (MySQL, PostgreSQL, MongoDB, Redis, Elasticsearch), Servidores web (Apache, Nginx, HAProxy), Colas de mensajes (RabbitMQ, Kafka), Plataformas en la nube (AWS, Azure, GCP), y Dispositivos de red via SNMP (Cisco, Ubiquiti, Dell). También soportamos métricas personalizadas a través de StatsD, exporters de Prometheus e instrumentación OpenTelemetry.
¿Cómo se integra con mi stack existente?
Bleemeo ofrece múltiples rutas de integración: instale nuestro agente Glouton para monitoreo de infraestructura sin configuración, envíe métricas via OpenTelemetry (OTLP), o conecte cuentas en la nube a través de integraciones nativas. Para notificaciones, nos integramos con Slack, PagerDuty, OpsGenie, Microsoft Teams, email, SMS y webhooks personalizados. No se requieren cambios de código para el monitoreo de infraestructura - simplemente instale el agente y los servicios se descubren automáticamente.
¿Su monitoreo afecta el rendimiento del sistema?
No. Glouton es extremadamente ligero — típicamente menos del 1% de CPU y menos de 100 MB de memoria. El agente recopila métricas de forma asíncrona y agrupa las transmisiones para minimizar la carga de red, nunca compite con tus cargas de producción.
¿Cómo garantizan la seguridad y privacidad de los datos?
La seguridad es fundamental para nuestra plataforma: todos los datos están cifrados en tránsito con TLS 1.3 y en reposo con AES-256, y se almacenan en la UE (región de París) conforme al RGPD. El agente recopila métricas del sistema y de los servicios — además de tus logs si usas la gestión de logs — y como Glouton es open source, puedes verificar exactamente qué sale de tus servidores. Cada agente se autentica con sus propias credenciales mediante conexiones con certificate pinning, y el acceso está protegido por permisos basados en roles y registro de auditoría. Nuestra infraestructura pasa por auditorías de seguridad regulares.
¿Soportan métricas y logs?
Si, Bleemeo proporciona observabilidad completa a través de métricas y logs. Las métricas se recopilan cada 10 segundos con 13 meses de retención. Los logs pueden recopilarse y centralizarse a través de nuestro agente con capacidades de búsqueda en tiempo real, filtrado y alertas. Ambos tipos de datos pueden correlacionarse en nuestros paneles para una resolución de problemas completa.
¿Qué tan rápido puedo comenzar con su solución?
Puedes estar operativo en menos de 5 minutos. Instala el agente Glouton con un solo comando — one-liner para Linux, instalador para Windows, o chart Helm para Kubernetes. El agente descubre automáticamente tus servicios y puebla los dashboards de inmediato.
¿Qué hace a su plataforma diferente de otras herramientas de monitoreo?
Bleemeo se destaca por: Simplicidad - el descubrimiento automático significa que no hay configuración manual de que monitorear. Agente de código abierto - Glouton es completamente código abierto, sin caja negra. Precios predecibles - precio por host sin cargos ocultos por métricas o volumen de datos. Retención larga - 13 meses incluidos, no 15 días. Empresa europea - residencia de datos en la UE y enfoque GDPR-first. Basado en estándares - soporte nativo de Prometheus y OpenTelemetry significa que no hay vendor lock-in.
¿Soportan OpenTelemetry y Prometheus?
Sí. Bleemeo soporta ambos estándares de forma nativa. Para Prometheus, nuestro agente hace scrape de tus exporters existentes y PromQL funciona sin configuración. Para OpenTelemetry, envía métricas y logs vía OTLP (gRPC o HTTP) — sin cambios en tu instrumentación.
Su solución es adecuada para entornos cloud-native e hibridos?
Si, Bleemeo esta disenado para infraestructura moderna. Para cloud-native: soportamos Kubernetes con visibilidad completa de cluster, nodo, pod y contenedor via despliegue con Helm. El descubrimiento automático maneja cargas de trabajo efimeras automáticamente. Para entornos hibridos: monitoree servidores on-premises, VMs en la nube, contenedores y servicios gestionados desde una sola plataforma. Nuestro agente funciona identicamente en todos los entornos, y los paneles pueden combinar métricas de todas las fuentes para una visibilidad unificada.
Últimos artículos del blog
Consejos, tutoriales y mejores prácticas para el monitoreo de infraestructura

Fiabilidad demostrable. Costes predecibles.
Listo para producción en 5 minutos — con el historial de disponibilidad para mostrar a tu dirección y precios por servidor para planificar tu presupuesto.
Prueba gratuitaSin tarjeta de crédito · 15 días de prueba gratuita · Acceso completo a todas las funciones