Zuverlässige Services ohne eigenes Monitoring-Team.Infrastructure Monitoring, das einfach funktioniert.
Bleemeo gibt Ihrem Team volle Sichtbarkeit über Server, Container und Kubernetes-Cluster — Dashboards, Alerts und Logs sind ab der ersten Installation einsatzbereit. Sie erkennen Störungen, bevor Ihre Kunden sie bemerken, Ihre Engineers bleiben beim Produkt, und die Abrechnung pro Host hält die Kosten planbar. Europäisches Unternehmen, Daten in der EU gespeichert.
Keine Kreditkarte erforderlich • 15 Tage kostenlos testen • In 5 Minuten produktionsbereit
Monitoring, das vorausdenkt
Ein Datum statt einer roten Kurve
Bleemeo sagt aus Ihrer eigenen Historie voraus, wann Festplatte, Arbeitsspeicher und Swap voll sind, und schreibt das Datum in Ihren Wochenbericht.
Anomalien markiert, niemand geweckt
Ein Chronos-Bolt-Modell lernt zwei Wochen jeder Metrik und markiert, was sein übliches Band verlässt. Kontext für die Bereitschaft, kein Weckruf um 3 Uhr.
Fragen Sie Ihren KI-Assistenten
Unser MCP-Server gibt Claude, ChatGPT, Mistral Le Chat oder Cursor über 30 schreibgeschützte Tools: PromQL-Abfragen, Metriken, Events und Logs.
Offene Standards, kein Lock-in
PromQL, Prometheus Remote Write und OpenTelemetry als Eingang; ein Open-Source-Agent in Go (Glouton) auf Ihren Hosts.
Eine Plattform
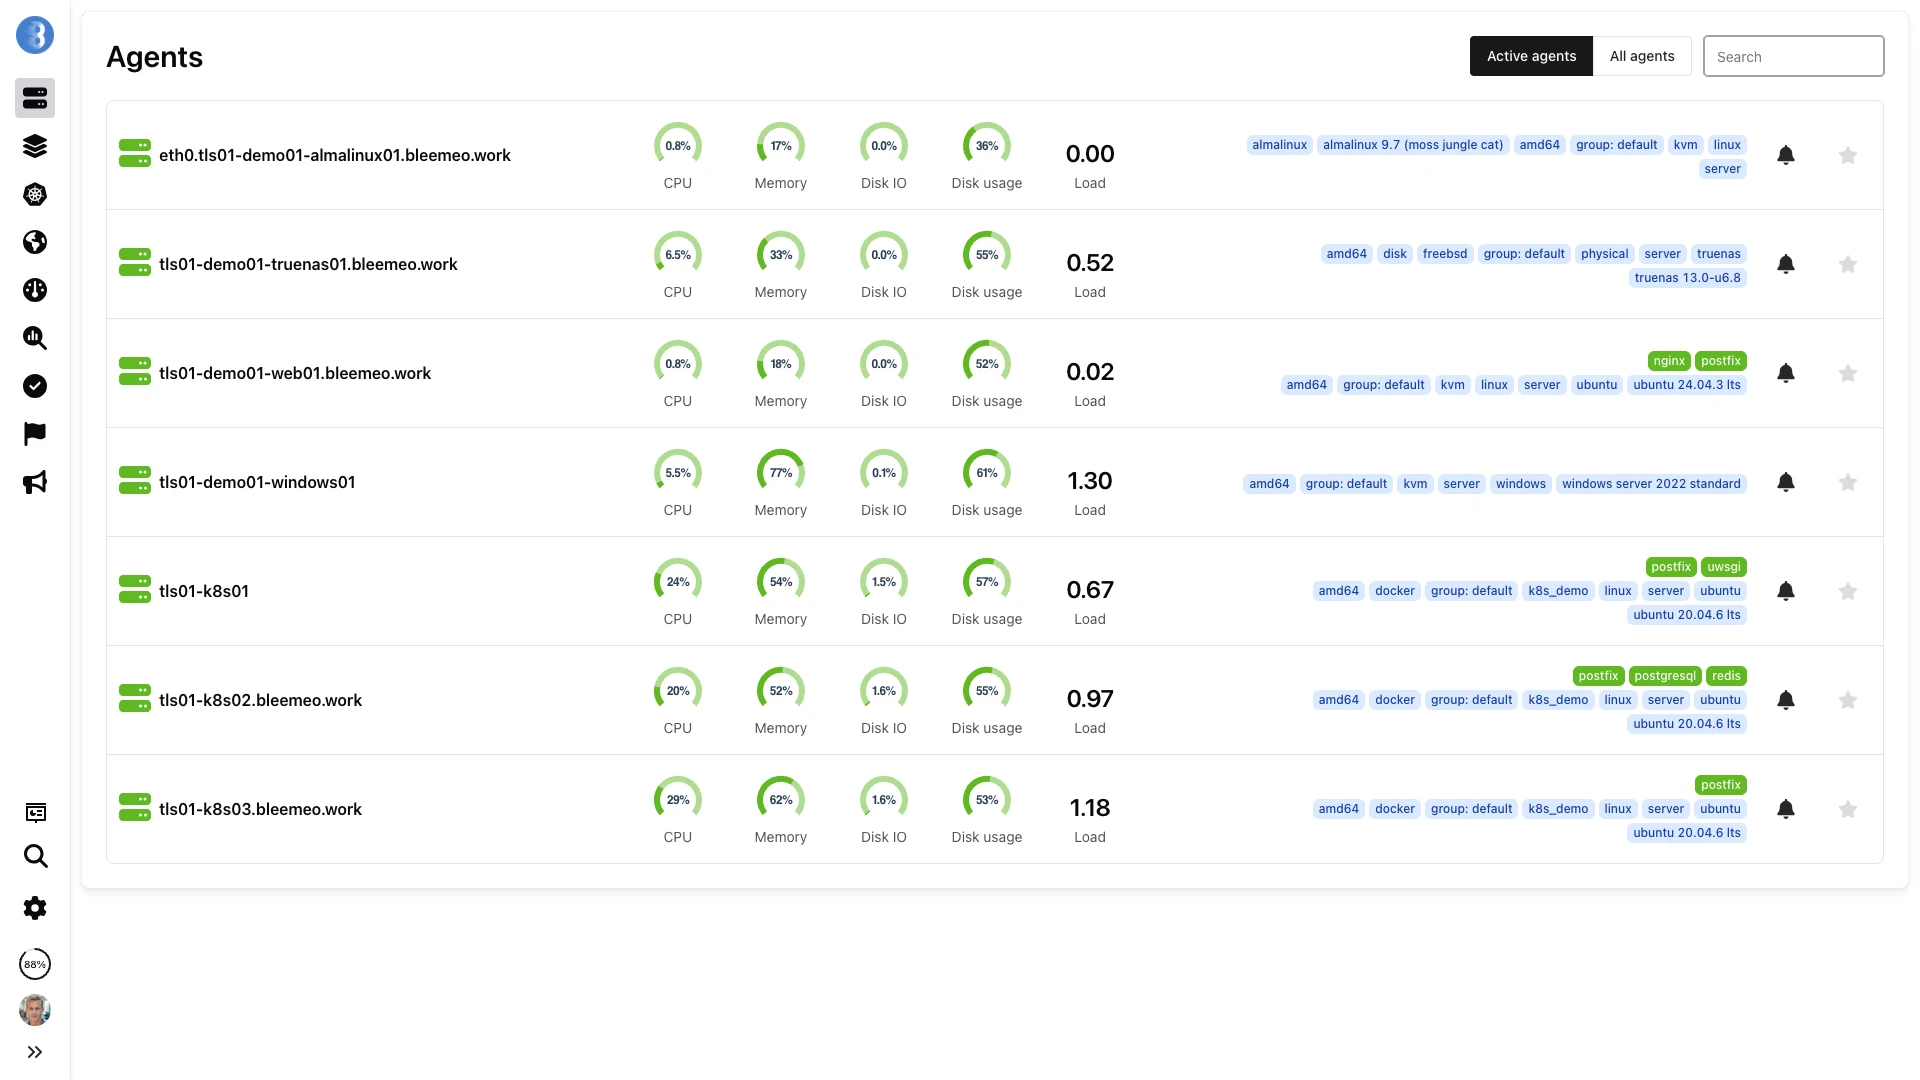
Jeder Server, Container und Service — ein Ort, um alles im Blick zu behalten
Installieren Sie einen Agenten auf Linux, Windows oder Kubernetes, und jeder Service auf der Maschine wird automatisch erkannt — MySQL, PostgreSQL, Redis, Nginx und viele mehr. AWS- und Azure-Services kommen über ihre APIs, Netzwerkgeräte per SNMP, und Logs landen im selben Tool. Eine Ansicht für Server, Container, Datenbanken und Clouds, ohne vier Produkte zusammenzustückeln.
Teams, die Features liefern statt Dashboards zu hüten
Von SaaS-Startups bis zum Mittelstand: 500+ Unternehmen verlassen sich auf Bleemeo, um ihre Produktion im Griff zu behalten

Was unsere Kunden sagen
Ingenieure und CTOs vertrauen auf Bleemeo für ihr Infrastruktur-Monitoring
Unsere Teams müssen sich auf unser Kerngeschäft konzentrieren können — Digital Signage — statt auf die Infrastrukturüberwachung. Bleemeo überwacht unsere gesamte Umgebung, vom dedizierten Server bis Azure, und befreit unsere Teams von unnötigen Alerts, während es gleichzeitig unsere Servicequalität sicherstellt.
Bleemeo war unglaublich schnell einzurichten. In etwa einer Stunde haben wir es auf über 100 Servern ausgerollt und sofort volle Sicht auf unsere Infrastruktur erhalten.
Wir haben Bleemeo in nur wenigen Stunden auf unserer gesamten Server-Infrastruktur ausgerollt. Das Uptime-Monitoring benachrichtigt uns jetzt sofort, wenn ein Dienst ein Problem hat.
Vergleich
Selbst bauen, zu viel zahlen oder einfach nutzen
Eigenen Stack bauen, eine Enterprise-Plattform kaufen oder den Mittelweg wählen: Das kostet jede Option wirklich, Engineering-Zeit inklusive.
DIY Open Source
Prometheus + Grafana + Alertmanager + Thanos + ... oder Zabbix, Nagios, Centreon, Checkmk- Wochen der Einrichtung und Feinabstimmung
- Laufende Wartung und Upgrades
- Speicherplanung und Kapazitätsmanagement
- Hochverfügbarkeit ist Ihr Problem
- Volle Kontrolle über alles
- Keine wiederkehrenden Lizenzkosten
Passend, wenn Sie bereits ein Plattform-Team mit Monitoring-Expertise haben — und die Zeit dafür.
- Funktionsreich und leistungsstark
- Verwaltete Infrastruktur
- Komplexe Preise: getrennte Posten für Hosts, Logs, APM und benutzerdefinierte Metriken
- Rechnungen, die schneller wachsen als Ihre Infrastruktur
- Steile Lernkurve für Mehrwert
- Oft mehr Tool als nötig
Für Großunternehmen mit großen Budgets und großen Teams gebaut.
Bleemeo
Schlüsselfertiges Monitoring für wachsende Teams- In 5 Minuten produktionsbereit
- Einfache Pro-Host-Preise, keine versteckten Gebühren
- Auto-Discovery von 100+ Technologien
- 13 Monate Aufbewahrung inklusive
- Prometheus- und OpenTelemetry-kompatibel
- Europäisches Unternehmen, EU-Datenresidenz
Die gesamte Sichtbarkeit, die Sie brauchen — ohne unnötige Komplexität.
Was Self-Hosting wirklich kostet
Wer überwacht das Monitoring?
Fällt Ihr Monitoring-Server zusammen mit dem Rest aus, bekommt niemand den Alarm. Bleemeo läuft außerhalb Ihrer Infrastruktur.
Updates und Sicherheitspatches
Prometheus, Grafana, Alertmanager und Thanos sind vier Release-Zyklen, denen man folgen muss. Bei Bleemeo keiner.
Hochverfügbarkeit
Mindestens zwei Instanzen, damit bei Wartungen keine Alarme verloren gehen.
Aufbewahrung
Prometheus behält standardmäßig 15 Tage; für mehr braucht es Thanos oder Mimir und Object Storage. Bleemeo behält 13 Monate im Professional-Tarif.
Für 50 Server über 3 Jahre zählt unser Rechner 17 Ingenieurtage pro Jahr für den Betrieb zu 450 € pro Tag, 14 Tage für die Installation und ein Hochverfügbarkeitspaar: 39.397 € im Eigenbetrieb, gegenüber 19.782 € mit Bleemeo Professional.
Selbst berechnen →Grundlagen
Was Ihr Team zurückgewinnt
Wir betreiben den gesamten Monitoring-Stack — Erfassung, Speicherung, Dashboards, Alerting und Langzeit-Retention —, und die Zeit, die Ihr Team in Prometheus, Grafana, Alertmanager und Thanos stecken würde, fließt zurück in Ihr Produkt.
Sichtbarkeit ab der ersten Minute
Installieren Sie einen einzigen Agenten und alles wird automatisch erkannt. Keine Exporter konfigurieren, keine Scrape-Targets verwalten, keine Dashboards von Grund auf bauen.
Eine Rechnung, die Sie planen können
Einfache Pro-Host-Preise ohne Überraschungsrechnungen. Im Professional-Plan enthält jeder Server 1.000 Metriken und 20 Container; Logs werden nutzungsbasiert pro GiB abgerechnet, und Benutzer, Dashboards und Alarme werden nie berechnet. Sie wissen immer, was Sie zahlen.
Alerts, bereits für Sie abgestimmt
Vorgefertigte Dashboards, Standard-Alarmregeln und 13 Monate Aufbewahrung inklusive. Echte Sichtbarkeit in Minuten, nicht Wochen der Einrichtung.
Nichts zu hosten, patchen oder aktualisieren
Vergessen Sie Speicherkapazität, Federation, Hochverfügbarkeit und Upgrades. Wir verwalten die Plattform — Sie nutzen sie einfach.
Alles, was man von Monitoring erwartet — inklusive
Die Grundlagen, die ein Monitoring-Tool beherrschen muss, an einem Ort, ohne dass auf unserer Seite etwas zu installieren ist.
Erfassen
- Linux- und Windows-Server
- Docker und Kubernetes
- SNMP-Netzwerkgeräte
- VMware vSphere, AWS und Azure
- 100+ Integrationen, Prometheus-Exporter, OTLP
- Eigene Checks, auch Nagios-Plugins
Sehen
- Echtzeit-Dashboards und Vorlagen
- 13 Monate Aufbewahrung (Professional)
- Log-Suche
- Uptime-Checks von 7 Standorten, SSL- und Domain-Ablauf
- Öffentliche Statusseiten
Alarmieren
- Standard-Schwellenwerte ab Werk
- PromQL-Alarmregeln
- Slack, Teams, PagerDuty, Opsgenie, ilert, E-Mail, SMS, Webhooks
- Bereitschaftspläne und Eskalation
- Stummschaltungen für Wartungsfenster
- Apps für iOS und Android
Verwalten
- Benutzer, Rollen und 2FA
- Audit-Log
- REST-API
- MCP-Server
- Wochenbericht
Server-Monitoring
Server-Monitoring, das sich selbst einrichtet
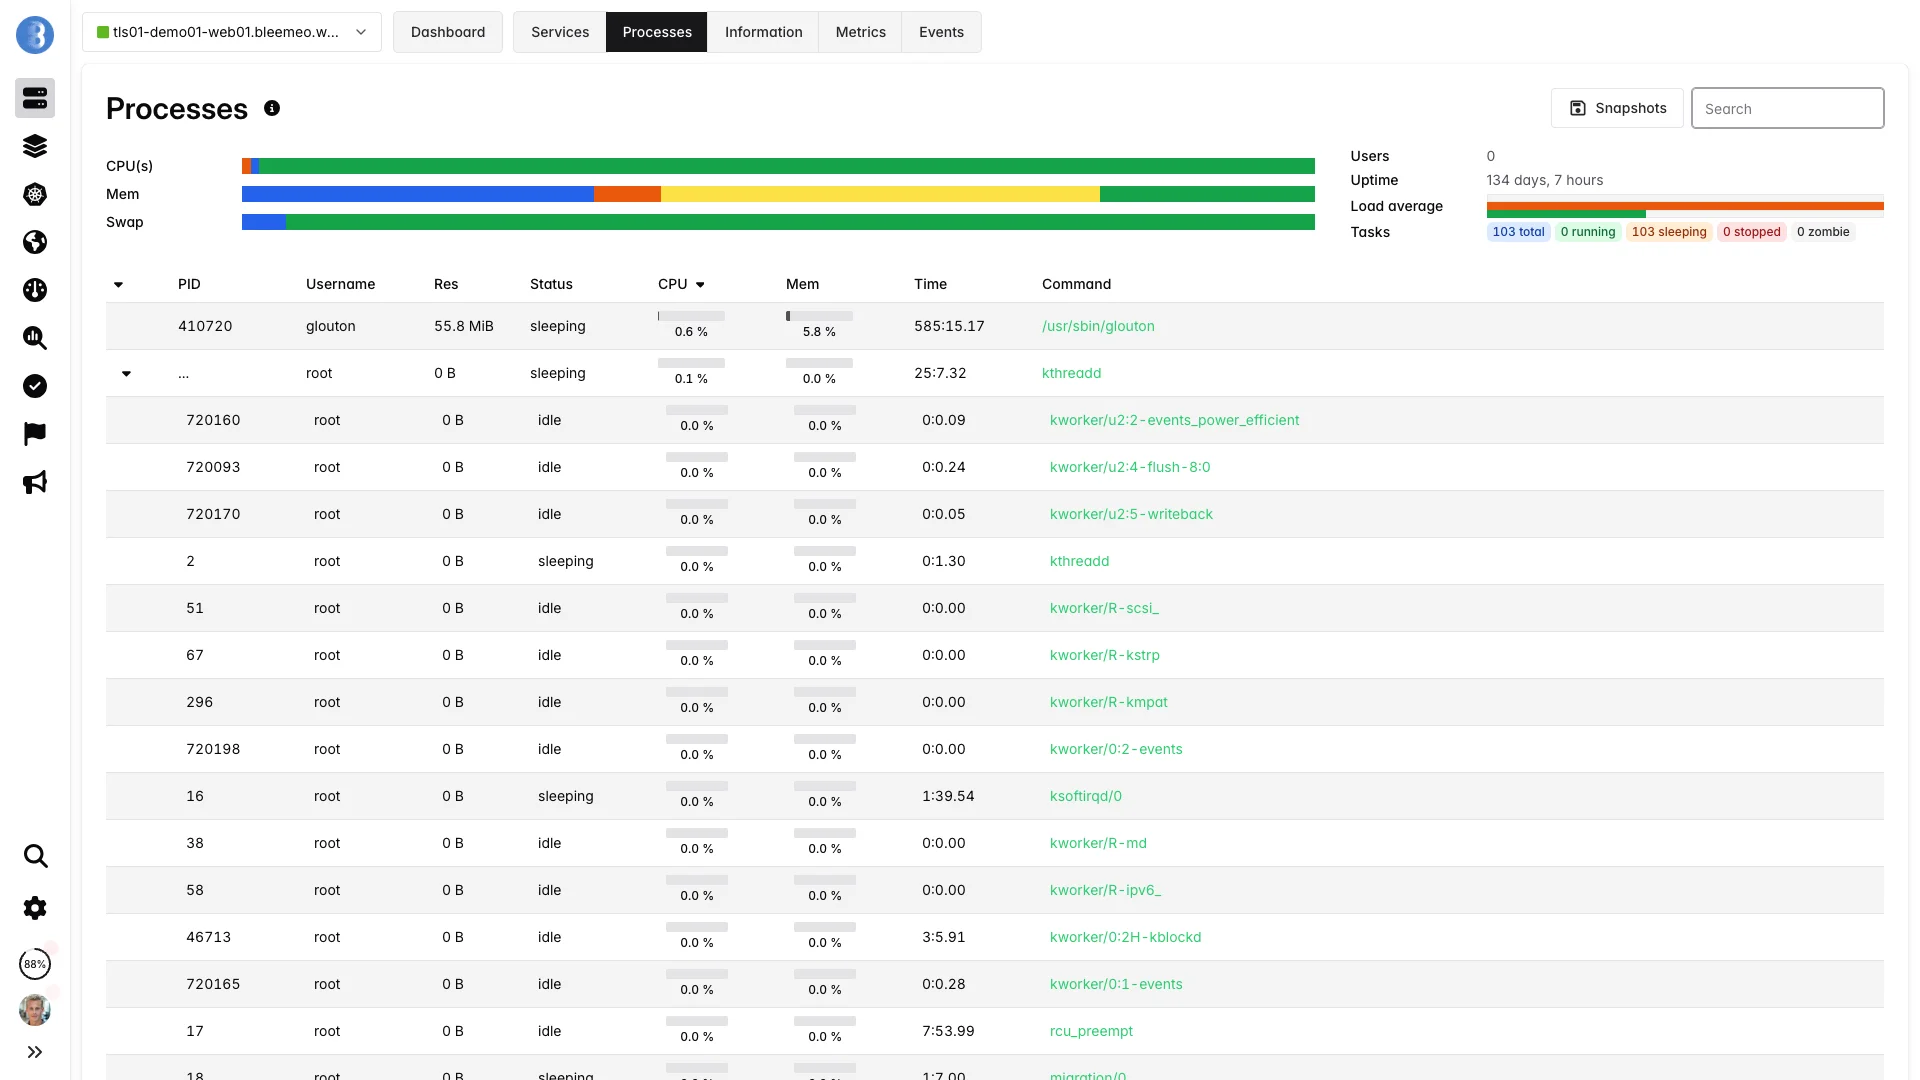
Die meisten Monitoring-Tools erfordern, dass Sie definieren was überwacht werden soll, Konfigurationsdateien schreiben und Dashboards bauen, bevor Sie eine einzige Metrik sehen. Mit Bleemeo installieren Sie einen leichtgewichtigen Agenten und er erledigt den Rest.
Glouton, unser Open-Source-Agent, erkennt automatisch jeden laufenden Dienst — Datenbanken, Webserver, Queues, Container — und beginnt mit der Metrik-Erfassung in 10-Sekunden-Auflösung. Dashboards und Alerts sind fertig, bevor Ihr Kaffee kalt wird.
Abdeckung
Von 5 bis 500 Servern, ein Tool
Umfassende Überwachung für jeden Teil Ihrer Infrastruktur
Server-Überwachung
Physische und virtuelle Server, VMs und Bare-Metal-Infrastruktur. Überwachen Sie Systemmetriken, Prozesse und Dienste.
Server-Monitoring entdecken →Kubernetes-Überwachung
Vollständige Kubernetes-Observability. Überwachen Sie Cluster, Nodes, Pods und Services mit automatischer Erkennung.
Kubernetes-Monitoring entdecken →Anwendungs-Überwachung
Überwachen Sie Datenbanken, Webserver, Nachrichtenwarteschlangen und benutzerdefinierte Anwendungen. Verfolgen Sie Leistung und Verfügbarkeit.
Application Monitoring entdecken →Container-Überwachung
Docker- und Container-Metriken. Überwachen Sie Ressourcennutzung, Zustand und Leistung über Ihre gesamte Container-Flotte.
Docker-Container-Monitoring entdecken →Netzwerk-Überwachung
Verfolgen Sie Netzwerkleistung, Bandbreitennutzung und Konnektivität. Überwachen Sie Switches, Router und Load Balancer.
Netzwerk-Monitoring entdecken →Cloud-Überwachung
AWS, Azure, GCP und Multi-Cloud-Umgebungen. Einheitliche Sichtbarkeit über Ihre gesamte Cloud-Infrastruktur.
AWS-Monitoring entdecken →Log-Management
Logs neben Ihren Metriken, abgerechnet pro GiB
Bei den meisten Monitoring-Anbietern sind Logs ein separates Produkt, das eigene Infrastruktur erfordert. Bei Bleemeo ist die Log-Erfassung in denselben Agenten integriert, den Sie bereits nutzen — kein ELK-Stack zu deployen, kein Loki zu konfigurieren. Sie zahlen nur für das, was Sie aufnehmen: 0,50€/GiB, ohne versteckte Indexierungsgebühren oder Aufbewahrungszuschläge.
Prometheus
Sie lieben Prometheus? Vergessen Sie den Ops-Aufwand.
Prometheus ist leistungsstark — und es in Produktion zu betreiben heißt, sich um Speicher, Retention, Federation, Hochverfügbarkeit und eine ganze Konstellation von Exportern zu kümmern.
Bleemeo bietet Ihnen volle PromQL-Kompatibilität mit verwaltetem Langzeitspeicher und 13 Monate Aufbewahrung. Behalten Sie die Abfragesprache, die Sie kennen — lassen Sie die Infrastruktur-Last fallen.
scrape_configs:
  - job_name: 'nodes'
    static_configs:
      - targets:
        - 'node1:9100'
        - 'node2:9100'

  - job_name: 'kubernetes'
    kubernetes_sd_configs:
- role: podOpenTelemetry
Bringen Sie Ihre Instrumentierung mit. Wechseln Sie, wann Sie wollen.
Sie nutzen bereits OpenTelemetry oder Prometheus-Exporter? Bleemeo akzeptiert Ihre Metriken und Logs unverändert. Keine proprietären Agenten, keine herstellerspezifischen SDKs. Ihre Instrumentierung bleibt portabel — wir geben ihr einfach ein Zuhause.
KI & ML
Früher gewarnt, seltener alarmiert
Kleine Teams können es sich nicht leisten, Fehlalarmen nachzulaufen. Bleemeo lernt den täglichen und wöchentlichen Rhythmus von CPU, Speicher und Swap jedes Servers und markiert die Stunden, die den erwarteten Bereich verlassen — ohne Schwellenwert und ohne jemanden zu wecken. Ein zweites Modell beantwortet die andere Frage: nicht «ist das gerade normal?», sondern «wann geht es aus?»
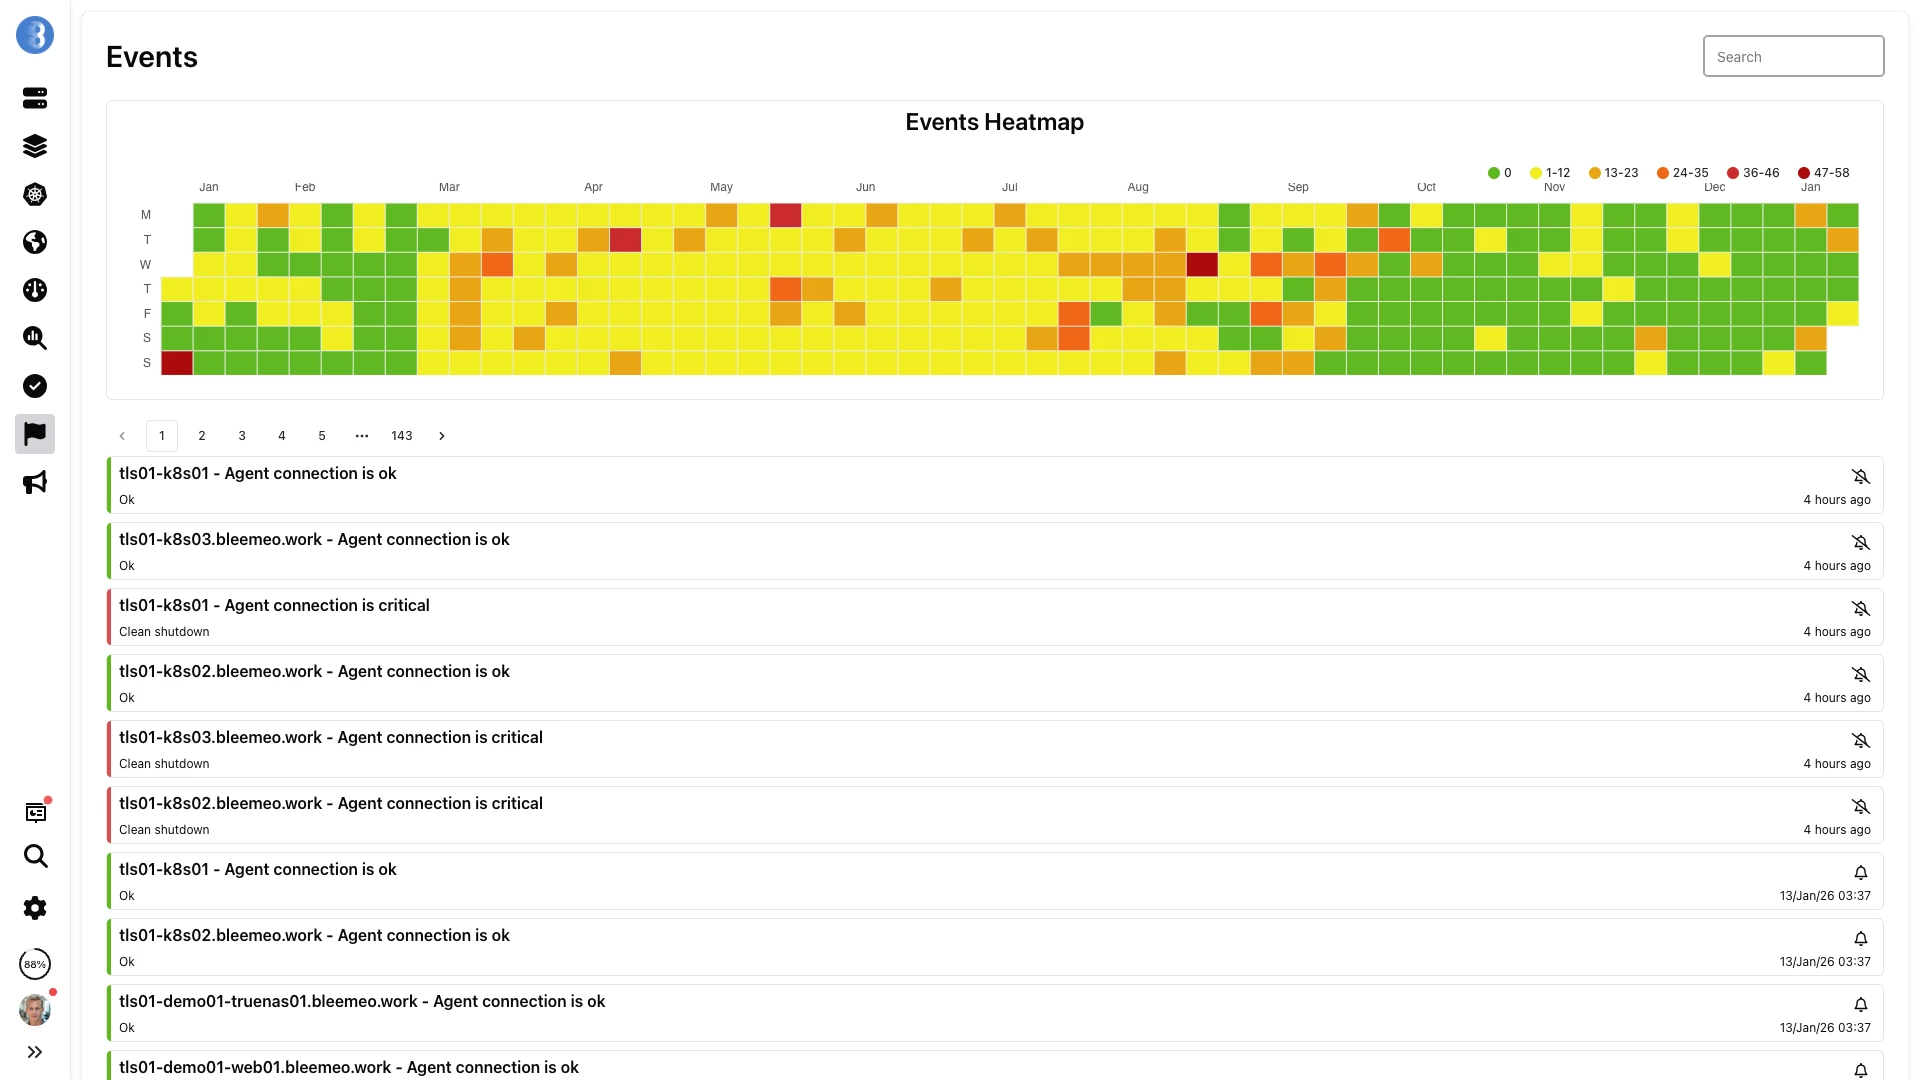
Ein Jahr Ereignisse auf einen Blick — dieselbe Historie, aus der die Modelle lernen, wie eine normale Woche aussieht.
Anomalieerkennung
Bleemeo lernt aus den letzten zwei Wochen den täglichen und wöchentlichen Rhythmus von CPU, Speicher und Swap jedes Servers und markiert die Stunden, die den erwarteten Bereich verlassen. Nichts zu konfigurieren, und es weckt Sie nie: Eine Anomalie ist ein Signal, keine Schweregrad-Stufe.
Kapazitätsprognose
Trends bei Festplatte, Speicher und Swap werden auf ein Datum hochgerechnet, nicht auf einen Prozentwert: «dieses Volume erreicht 90 % am 3. April». Ein Datum wird nur genannt, wenn die Drift sich über zwei Fenster bestätigt hat — ein Dienst, der startet und die Hälfte des RAM nimmt, ist kein Leck.
Gemessener Vorlauf
Jede Anomalie wird dem ersten Alarm zugeordnet, der ihr auf demselben Host folgte: Die Oberfläche zeigt den echten Abstand — «Alarm 42 Minuten später» — und den medianen Vorlauf pro Ansicht. Sie sehen, was die Erkennung auf Ihrer eigenen Infrastruktur wert ist.
Sie lernt aus Ihren Antworten
Jede Anomalie erwartet ein Ja oder Nein. Wiederholte Fehlalarme pausieren die Erkennung für diese Metrik von selbst: Ein verrauschtes Signal verstummt, statt Ihrem Team beizubringen, die Funktion zu ignorieren.
Vorschläge zur Rauschreduzierung Beta
Bleemeo gruppiert Ihre wiederkehrenden Alarme und schlägt die Silence- oder Flappy-Konfiguration vor, die sie beruhigen würde — vorbefüllt und einen Klick entfernt. Durchsuchen Sie Ihre Ereignishistorie nach Bedeutung statt nach exaktem Wortlaut, und fragen Sie, ob so etwas schon einmal aufgetreten ist.
MCP-Server für KI-Assistenten
Verbinden Sie Claude, Cursor oder VS Code über unseren Model-Context-Protocol-Server. Über 30 schreibgeschützte Tools erlauben einem Assistenten, Fragen zur Gesundheit Ihrer Infrastruktur zu beantworten — er kann alles lesen und nichts ändern.
Sicherheit
Ihre Monitoring-Daten sind eine Landkarte Ihrer Infrastruktur. Entsprechend schützen wir sie.
Sicherheit ist kein Add-on und kein Enterprise-Feature — sie steckt in jeder Schicht der Plattform, vom Agent auf Ihren Servern bis zum Speicher, in dem Ihre Metriken und Logs aufbewahrt werden.
Jeder Agent authentifiziert sich beim Bleemeo-Cloud mit eindeutigen Zugangsdaten, die an Ihr Konto gebunden sind. Es gibt keine anonymen Datenströme und keine gemeinsamen Endpunkte — jede Metrik-Quelle wird verifiziert, bevor ein einziger Datenpunkt akzeptiert wird. So wissen Sie immer genau, was in Ihr Konto berichtet wird, und nichts Unbefugtes kann falsche Daten in Ihre Dashboards einschleusen.
- TLS 1.3-Verschlüsselung für alle Daten während der Übertragung
- AES-256-Verschlüsselung für alle gespeicherten Daten
- Authentifizierung pro Agent mit eindeutigen Zugangsdaten
- Rollenbasierte Zugriffskontrolle und Audit-Protokollierung
Europäisch
Ein europäisches Unternehmen, nicht bloß eine europäische Region
Ein Rack in Frankfurt kann jeder Anbieter mieten. Weniger können Ihnen sagen, mit welchem Unternehmen Sie den Vertrag schließen, nach welchem Recht, und was genau Ihre Server verlässt.
Sie schließen den Vertrag mit einem französischen Unternehmen
Bleemeo ist ein französisches Unternehmen, 2015 in Toulouse gegründet und von dort geführt. Abgerechnet wird in Euro, nach französischem Recht, mit einem tatsächlich erreichbaren Datenschutzbeauftragten und Support in Ihrer Zeitzone — keine US-Gesellschaft mit angehängter EU-Tochter.
Ihre Metriken bleiben in der Region Paris
Metriken und Logs werden in der Europäischen Union gespeichert, in der Region Paris. Eine Region, eine Rechtsordnung, benannt — statt der «europäischen Rechenzentren», die alle schreiben. Die vollständige Liste der Auftragsverarbeiter, einschließlich der wenigen außerhalb der EU auf Basis von Standardvertragsklauseln, steht auf der Sicherheitsseite.
Keine Blackbox auf Ihren Servern
Glouton, der Agent, den Sie installieren, ist Open Source unter Apache 2.0. Was er erfasst und was er sendet, lässt sich Zeile für Zeile nachlesen. Wer einen Lieferanten rechtfertigen muss, hat damit eine stärkere Zusicherung als ein Residenz-Siegel.
Öffentliche Statusseite
Zeigen Sie Ihren Kunden die Verfügbarkeit, die Sie liefern
Dieselben Checks, die Ihr Team alarmieren, speisen auch eine öffentliche Statusseite unter Ihrer eigenen Domain: Service-Zustand in Echtzeit, laufende Störungen und Verfügbarkeitshistorie. Eine URL, die Ihr Support während einer Störung teilen kann — ohne separates Statusseiten-Tool und ohne manuelle Pflege.
Uptime-Monitoring entdecken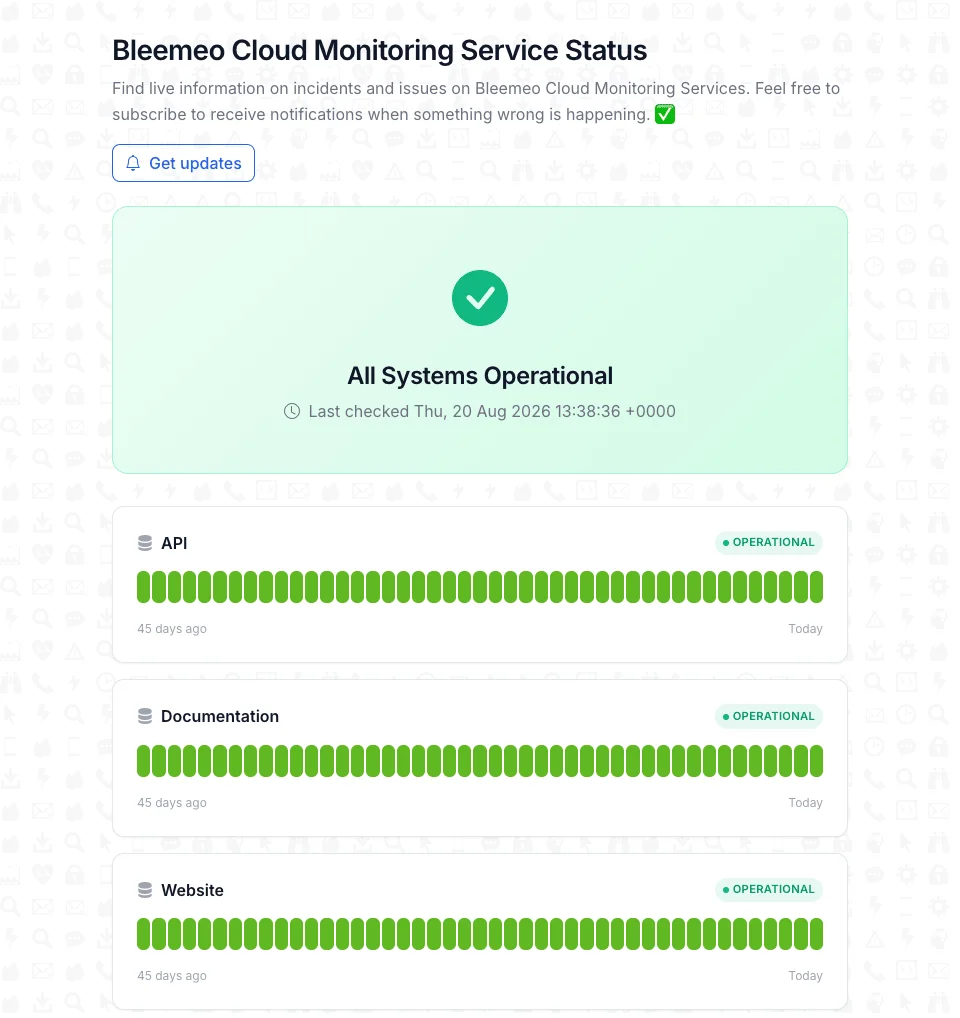
Das ist Bleemeos eigene Statusseite — live ansehen.
Häufig gestellte Fragen
Alles, was Sie über Bleemeos Monitoring-Plattform wissen müssen
Wie funktioniert Ihre Monitoring-Plattform?
Bleemeo verwendet einen leichtgewichtigen Open-Source-Agenten namens Glouton, den Sie auf Ihren Servern, VMs oder Kubernetes-Clustern installieren. Der Agent erkennt automatisch laufende Dienste und Anwendungen, sammelt alle 10 Sekunden Systemmetriken und überträgt Daten sicher an unsere Cloud-Plattform. Von dort erhalten Sie Echtzeit-Dashboards, intelligente Alarmierung und 13 Monate Metrik-Aufbewahrung. Für Cloud-Dienste integrieren wir direkt mit AWS CloudWatch und Azure Monitor. Die Plattform akzeptiert auch Daten über OpenTelemetry (OTLP) Protokolle.
Welche Arten von Infrastruktur und Anwendungen unterstützen Sie?
Bleemeo unterstützt über 100 Technologien von Haus aus mit automatischer Erkennung. Dazu gehören: Betriebssysteme (Linux, Windows), Container (Docker, containerd, Kubernetes), Datenbanken (MySQL, PostgreSQL, MongoDB, Redis, Elasticsearch), Webserver (Apache, Nginx, HAProxy), Nachrichtenwarteschlangen (RabbitMQ, Kafka), Cloud-Plattformen (AWS, Azure, GCP) und Netzwerkgeräte über SNMP (Cisco, Ubiquiti, Dell). Wir unterstützen auch benutzerdefinierte Metriken über StatsD, Prometheus-Exporter und OpenTelemetry-Instrumentierung.
Wie integrieren Sie sich in meinen bestehenden Stack?
Bleemeo bietet mehrere Integrationspfade: Installieren Sie unseren Glouton-Agenten für Infrastruktur-Monitoring ohne Konfiguration, senden Sie Metriken und Logs über OpenTelemetry (OTLP), oder verbinden Sie Cloud-Konten über native Integrationen. Für Benachrichtigungen integrieren wir mit Slack, PagerDuty, OpsGenie, Microsoft Teams, E-Mail, SMS und benutzerdefinierten Webhooks. Keine Code-Änderungen für Infrastruktur-Monitoring erforderlich - installieren Sie einfach den Agenten und Dienste werden automatisch erkannt.
Beeinträchtigt Ihr Monitoring die Systemleistung?
Nein. Glouton ist extrem leichtgewichtig — typischerweise unter 1% CPU und weniger als 100 MB Speicher. Der Agent sammelt Metriken asynchron und bündelt die Übertragung, um die Netzwerklast zu minimieren, er konkurriert nie mit Ihren Produktionslasten.
Wie gewährleisten Sie Datensicherheit und Datenschutz?
Sicherheit ist fundamental für unsere Plattform: Alle Daten werden während der Übertragung mit TLS 1.3 und im Ruhezustand mit AES-256 verschlüsselt und DSGVO-konform in der EU (Region Paris) gespeichert. Der Agent sammelt System- und Service-Metriken — sowie Ihre Logs, wenn Sie das Log-Management nutzen — und da Glouton Open Source ist, können Sie genau prüfen, was Ihre Server verlässt. Jeder Agent authentifiziert sich mit eigenen Zugangsdaten über Verbindungen mit Certificate Pinning, und der Zugriff ist durch rollenbasierte Berechtigungen und Audit-Logging geschützt. Unsere Infrastruktur unterliegt regelmäßigen Sicherheitsaudits.
Unterstützen Sie Metriken und Logs?
Ja, Bleemeo bietet umfassende Observability für Metriken und Logs. Metriken werden alle 10 Sekunden mit 13 Monate Aufbewahrung gesammelt. Logs können über unseren Agenten zentralisiert werden mit Echtzeit-Suche, Filterung und Alarmierungsfähigkeiten. Beide Datentypen können in unseren Dashboards für umfassende Fehlerbehebung korreliert werden.
Wie schnell kann ich mit Ihrer Lösung starten?
Sie können in unter 5 Minuten einsatzbereit sein. Installieren Sie den Glouton-Agenten mit einem einzigen Befehl — One-Liner für Linux, Installer für Windows oder Helm-Chart für Kubernetes. Der Agent erkennt automatisch Ihre Dienste und füllt die Dashboards sofort.
Was unterscheidet Ihre Plattform von anderen Monitoring-Tools?
Bleemeo zeichnet sich aus durch: Einfachheit - automatische Erkennung bedeutet keine manuelle Konfiguration dessen, was überwacht werden soll. Open-Source-Agent - Glouton ist vollständig Open-Source, keine Blackbox. Vorhersehbare Preisgestaltung - Pro-Host-Preise ohne versteckte Metrik- oder Datenvolumengebühren. Lange Aufbewahrung - 13 Monate inklusive, nicht 15 Tage. Europäisches Unternehmen - EU-Datenresidenz und DSGVO-First-Ansatz. Standards-basiert - native Prometheus- und OpenTelemetry-Unterstützung bedeutet keine Herstellerbindung.
Unterstützen Sie OpenTelemetry und Prometheus?
Ja. Bleemeo unterstützt beide Standards nativ. Für Prometheus scrapet unser Agent Ihre bestehenden Exporter und PromQL funktioniert sofort. Für OpenTelemetry senden Sie Metriken und Logs via OTLP (gRPC oder HTTP) — keine Instrumentierungsänderungen nötig.
Ist Ihre Lösung für Cloud-native und hybride Umgebungen geeignet?
Ja, Bleemeo ist für moderne Infrastruktur konzipiert. Für Cloud-native: Wir unterstützen Kubernetes mit vollständiger Cluster-, Node-, Pod- und Container-Sichtbarkeit über Helm-Deployment. Auto-Discovery behandelt kurzlebige Workloads automatisch. Für hybride Umgebungen: Überwachen Sie On-Premises-Server, Cloud-VMs, Container und verwaltete Dienste von einer einzigen Plattform aus. Unser Agent funktioniert in allen Umgebungen identisch, und Dashboards können Metriken aus allen Quellen für einheitliche Sichtbarkeit kombinieren.
Neueste Blog-Artikel
Einblicke, Tutorials und Best Practices für Infrastruktur-Überwachung

Nachweisbare Zuverlässigkeit. Planbare Kosten.
In 5 Minuten produktionsbereit — mit der Verfügbarkeitshistorie für Ihre Stakeholder und Preisen pro Host für Ihre Budgetplanung.
Kostenlos testenKeine Kreditkarte erforderlich - 15 Tage kostenlose Testversion - Voller Funktionszugang